
Stellen Sie sich vor, ein Mitarbeiter öffnet den internen HR-Assistenten Ihres Unternehmens und stellt eine einfache Frage: „Wie hoch ist das Gehalt eines SDE 2 hier?“ Innerhalb weniger Sekunden antwortet die KI mit einer detaillierten Zusammenfassung, die die tatsächlichen Vergütungsdaten der Mitarbeiter im gesamten Unternehmen enthält.
Es wurden keine Sicherheitsvorkehrungen umgangen. Es wurde keine Datenbank kompromittiert. Das System hat lediglich Informationen abgerufen, die es niemals hätte preisgeben dürfen.
Dies ist eine der größten Sicherheitsherausforderungen für KI-Implementierungen in Unternehmen. Retrieval-Augmented Generation (RAG)-Systeme zeichnen sich durch ihre Fähigkeit aus, relevante Informationen in umfangreichen Dokumentensammlungen, Tabellenkalkulationen und Wissensdatenbanken zu finden. Dennoch bleibt die Zugriffskontrolle eine der größten Sicherheitslücken im Bereich KI: 97 % der KI-bezogenen Sicherheitsvorfälle betreffen Systeme ohne angemessene Autorisierungskontrollen.
Ohne eine in den Abrufprozess integrierte feingranulare Autorisierung (FGA) verfügt das System über keine zuverlässige Möglichkeit, zwischen relevanten Informationen und Informationen, zu deren Zugriff der Benutzer tatsächlich berechtigt ist, zu unterscheiden.
Dieser Artikel erklärt, warum die Abrufschicht die eigentliche Sicherheitsgrenze in modernen RAG-Architekturen darstellt, wo traditionelle rollenbasierte Zugriffskontrollen versagen, und wie eine fein abgestufte Autorisierung verhindert, dass unautorisierte Daten jemals in das Kontextfenster des LLM gelangen.
Das Problem mit der Gehaltsabrechnung: Wenn hilfreiche KI zur Verletzung der Privatsphäre wird
Ein Unternehmen führt einen internen Assistenten ein, der mit Personaldokumenten, Projekt-Wikis, Gehaltsabrechnungen und Richtliniendateien verknüpft ist. Das Ziel ist klar: Mitarbeiter sollen schneller Antworten erhalten, ohne in Ordnern suchen oder auf die Personalabteilung warten zu müssen.
Dann stellt jemand eine direkte Frage zur Vergütung.
Die RAG-Pipeline erfüllt exakt ihren Zweck. Sie durchsucht die Vektordatenbank, findet die relevante Kompensationstabelle, ruft die passenden Zeilen ab und übergibt diesen Kontext an das LLM. Das Modell fasst die Zeilen zusammen und liefert das Ergebnis.
Das System hat zu keinem Zeitpunkt etwas „gehackt“. Es hat lediglich die Daten abgerufen, auf die es Zugriff hatte. Der Fehler lag in der Architektur. Die Abrufschicht besaß keine Kontrollmechanismen, sodass eine fein abgestufte Autorisierungskontrolle an den entscheidenden Stellen fehlte.
„Die KI hat die Daten nicht durchgesickert. Die RAG-Pipeline hat sie abgerufen. Diese Unterscheidung ist wichtig: Ein Abrufproblem lässt sich nicht mit einem Filter auf der Generationsebene beheben.“
Das ist der eigentliche Kern des Problems. Die LLM ist nicht das Problem. Die Abrufschicht hatte keine Autorisierungskontrollen und behandelte daher semantisch relevante Daten wie autorisierte Daten. Das ist nicht dasselbe, und in einem RAG-System entscheidet genau dieser Unterschied darüber, ob der Assistent hilfreich ist oder einen Datenschutzverstoß darstellt.
Wie RAG tatsächlich funktioniert
Stellen Sie sich RAG wie einen Rechercheassistenten vor, der jedes Dokument in Ihrem Aktenschrank gelesen hat. Sie stellen eine Frage, und der Assistent eilt zum Schrank, holt die relevantesten Seiten heraus und liest sie Ihnen vor. Es ist schnell, präzise und nützlich.
Wenn sich in diesem Schrank aber sowohl Ordner mit der Aufschrift „VERTRAULICH – NUR FÜR DIE PERSONALABTEILUNG“ als auch Ordner mit der Aufschrift „ÖFFENTLICHER ZUGRIFF“ befinden und der Assistent einen Generalschlüssel für alles hat, dann bieten die Etiketten keinen Schutz mehr.
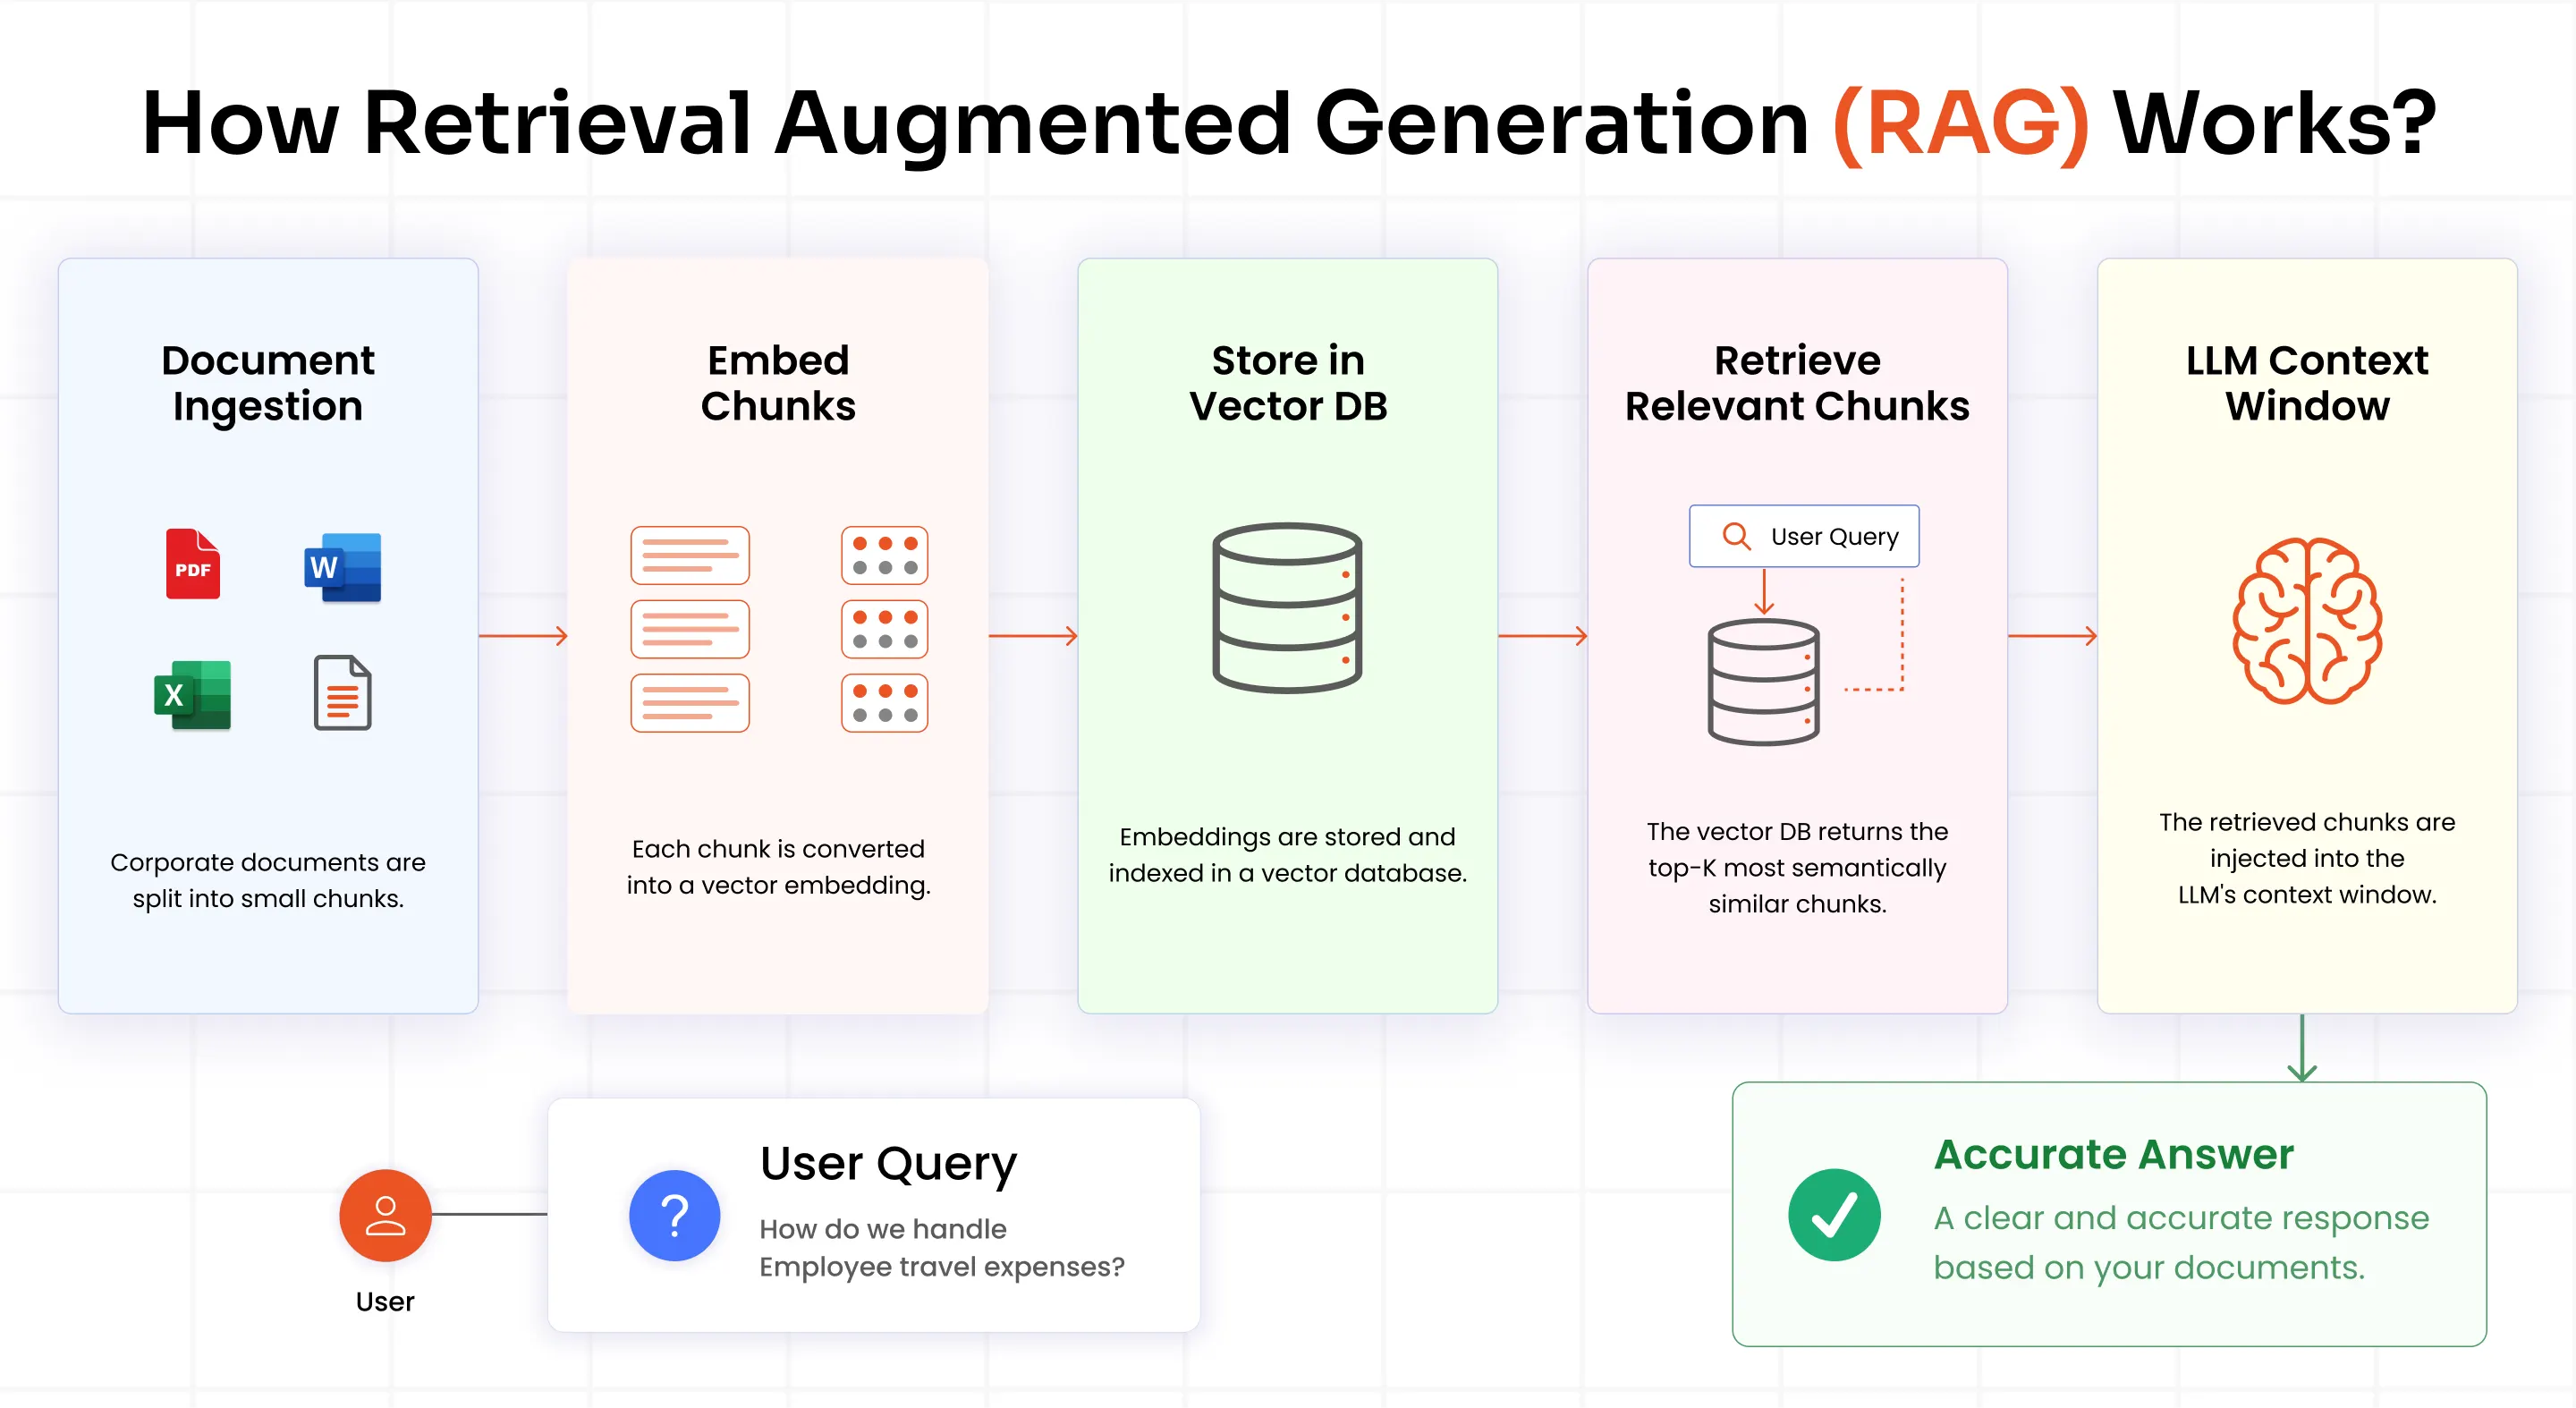
Der technische Arbeitsablauf folgt einem spezifischen, sequenziellen Pfad:
- Unternehmensdokumente werden in kleinere Einheiten wie Absätze, Zeilen oder Abschnitte unterteilt.
- Jeder Datenblock wird in eine Vektoreinbettung umgewandelt, die eine mathematische Repräsentation seiner Kernbedeutung darstellt.
- Diese Einbettungen werden in einem System gespeichert und indiziert. Vektordatenbank (Pinecone, Weaviate, pgvector) zur Ermöglichung schneller Suchvorgänge.
- Wenn ein Benutzer eine Anfrage absendet, wird diese spezifische Anfrage auch in ein Vektor-Embedding umgewandelt.
- Das System fragt die Vektordatenbank ab, um die K semantisch ähnlichsten Abschnitte zurückzugeben.
- Diese spezifischen Datenblöcke werden als Bezugskontext in das Kontextfenster des LLM eingefügt.
- Das LLM generiert eine klare, natürlichsprachliche Antwort, die ausschließlich auf den ihm vorgegebenen Textfragmenten basiert.
Hier wird die Autorisierung der Vektordatenbank entscheidend.
Wichtige Erkenntnis:
RAG optimiert standardmäßig auf Relevanz, und „Top-K ähnliche“ ist nicht dasselbe wie „Top-K autorisiert“.
Wo das Datenleck tatsächlich auftritt – beim Abruf, nicht bei der Erzeugung.
Viele Sicherheitsteams gehen fälschlicherweise davon aus, dass das Hauptrisiko beim Einsatz von KI darin besteht, dass das LLM zusätzliche Daten generiert oder durch geschickte Abfragen umgangen wird. Das eigentliche Sicherheitsrisiko entsteht jedoch viel früher im Prozess der standardmäßigen Dokumentenerfassung.
Um dies zu verstehen, wollen wir den genauen Ablauf des Lecks der Gehaltstabelle nachzeichnen:
- Schritt 1: Benutzeranfrage
Ein Mitarbeiter fragt die Benutzeroberfläche: „Wie hoch ist das Gehalt eines SDE 2 in unserem Unternehmen?“
- Schritt 2: Vektorsuche
Die Pipeline bettet diese Abfrage ein und durchsucht den Vektorspeicher. Da die Kompensationstabelle semantisch mit der Abfrage übereinstimmt, erscheint sie ganz oben in den Suchergebnissen.
- Schritt 3: Abrufen
Die Vergütungszeilen mit den Daten aller Mitarbeiter werden abgerufen und an das LLM übergeben. Die Abfrageschicht verfügt über keinen Mechanismus, um zu prüfen, ob der anfragende Mitarbeiter die Berechtigung zum Anzeigen dieser Daten besitzt; sie weiß lediglich, dass die Daten dem Thema entsprechen.
- Schritt 4: Generierung
Das LLM empfängt die Rohdaten zur Vergütung in seinem Kontextfenster und fasst den Text präzise zusammen. Das Modell erfüllt exakt seinen Zweck.
- Schritt 5: Offenlegung
Der Mitarbeiter erhält eine detaillierte Aufschlüsselung der Gehälter seiner Kollegen. Der Datenverlust ist vollständig und ereignete sich vollständig im Rahmen des normalen Systembetriebs.
Entscheidende Erkenntnis: Sobald Daten in das Kontextfenster des LLM gelangen, wird die Sicherheitsgrenze durchbrochen. Ein Filter der Generationsebene kann Daten, die dem Modell bereits zugänglich gemacht wurden, nicht mehr rückgängig machen. Die Autorisierung muss vor dem Abruf erfolgen, nicht danach.
Das ist der entscheidende Punkt. Fehlt eine detaillierte Autorisierung beim Abruf, ist das LLM nicht die Schwachstelle. Es ist lediglich der letzte Schritt, der Daten offenlegt, die niemals hätten bereitgestellt werden dürfen.
Was ist eine feingranulare Autorisierung (FGA)?
Bei der Betrachtung der Zugriffskontrolle in Unternehmen fragen sich die Beteiligten oft: Was ist feingranulare Autorisierung ? Es handelt sich um ein Autorisierungsmodell, das Zugriffsentscheidungen auf der Ebene einzelner Ressourcen trifft, wie z. B. bestimmter Dokumente, Zeilen, Absätze oder Datenobjekte, anstatt auf der allgemeinen Ebene von Rollen oder Ressourcentypen.
Um die feingranulare Autorisierung vollständig zu verstehen, ist es hilfreich, sie direkt mit traditionellen Modellen zu vergleichen. Während die standardmäßige rollenbasierte Zugriffskontrolle fragt, ob ein Benutzer die allgemeine Bearbeiterrolle besitzt, fragt ein feingranulares Autorisierungsmodell , ob dieser spezifische Benutzer die Berechtigung hat, auf diesen spezifischen Dokumentabschnitt in diesem spezifischen Kontext und genau jetzt zuzugreifen.
| Abmessungen | RBAC (grobkörnig) | FGA (Feinkörnig) |
|---|---|---|
| Zugangsentscheidung basierend auf | Allgemeine Benutzerrolle | Nutzer, Ressource, Beziehung und Kontext |
| Körnung | Ressourcentyp (z. B. „Personaldokumente“) | Einzelne Ressource (z. B. „Tabellenzeile 47“) |
| Echtzeitkontext | Nein | Ja (Risikobewertung, Zeit, Gerät, Delegationsbereich) |
| Dynamische Berechtigungsänderungen | Manuelle, langsame Aktualisierungen | Sofortige Ausführung ohne Daten-Neuindizierung |
| Geeignet für RAG | Nein, der Rahmen ist zu breit gefasst. | Ja, ermöglicht die Durchsetzung pro Chunk. |
| Beispiel | "Das HR-Team kann alle HR-Dokumente lesen." | „Mitarbeiter können ihre eigene Zeile lesen; Manager können die Zeilen ihres Teams lesen.“ |
Wesentlicher Unterschied: RBAC gewährt Zugriff auf eine breite Datenkategorie. FGA gewährt Zugriff auf spezifische Daten, basierend ausschließlich auf der Beziehung zwischen Benutzer, Ressource und aktuellem Betriebskontext.
In modernen technischen Architekturen dient OpenFGA als hervorragende Open-Source-Implementierung des Zanzibar-Papers von Google. OpenFGA wird von der CNCF gepflegt und stellt die grundlegenden Mechanismen für beziehungsbasierte Autorisierung bereit, die für feingranulare Steuerungen in großem Umfang erforderlich sind. Die miniOrange-FGA-Implementierung ist vollständig kompatibel mit diesem speziellen Autorisierungsmodell. ( Quellcode : openfga.dev)
Warum RBAC für RAG nicht ausreicht – und wo es an seine Grenzen stößt
Der Vergleich von FGA und RBAC verdeutlicht, warum herkömmliche, grobkörnige Sicherheitsmodelle bei der Anwendung auf generative KI-Pipelines versagen. Verlässt man sich ausschließlich auf Standard-RBAC, erscheint die Zugriffskontrollbewertung für eine Dokumentensuche einfach:
- Benutzer-Rolle: Mitarbeiter
- Zugewiesene Berechtigung: Kann Personaldokumente lesen
- Systemergebnis: Zugang gewährt
Die Schwachstelle besteht darin, dass „HR-Dokumente“ eine extrem breite Kategorie und nicht nur eine einzelne, spezifische Datei darstellt. Da alle Mitarbeitenden über diese allgemeine rollenbasierte Zugriffsberechtigung verfügen, behandelt die RAG-Pipeline beim Abruf die gesamte Bibliothek als frei zugänglich. Dadurch können sensible Gehaltsdaten zusammen mit Standard-Urlaubsplänen eingelesen werden.
Durch die Verwendung einer fein abgestuften Autorisierung zusätzlich zu RBAC wird dieser strukturelle Mangel behoben, indem explizite Beziehungen auf Objektebene modelliert werden:
- Benutzeridentifizierung: Mitarbeiter A
- Definierte Beziehung: Ist für seine/ihre persönliche Personalakte verantwortlich; berichtet an Manager X
- Systemseitig erzwungene Berechtigung: Mitarbeiter A kann seine eigene Zeile einsehen. Manager X kann die Zeilen seiner direkten Mitarbeiter einsehen. Die Personalabteilung kann alle Zeilen einsehen. Es gibt keine weiteren Zugriffswege.
Dieser komplexe Beziehungsgraph wird für jeden einzelnen Datenblock in Echtzeit ausgewertet. Die RAG-Pipeline fragt den Autorisierungsdienst ab, bevor sie ein Datenfragment in die endgültige Top-K-Kontextabfrage aufnimmt. Falls der anfragende Benutzer keine verifizierte Beziehung zu diesem Datenblock hat, filtert das System ihn vollständig heraus.
Stellen Sie sich folgende Analogie vor: RBAC ist wie ein Generalpass für einen Mitarbeiter, der ihm Zugang zum gesamten Personalarchiv des Unternehmens gewährt. FGA funktioniert wie die Ausgabe eines individuellen Schlüssels an jeden Mitarbeiter, der nur seinen jeweiligen Ordner öffnet, während der Vorgesetzte einen Schlüssel erhält, der die Dateien seines Teams öffnet, aber sonst nichts.
Die drei Säulen der FGA für RAG-Pipelines
Der Aufbau einer sicheren KI-Strategie erfordert die Implementierung spezialisierter, fein abgestufter Autorisierungsrichtlinien, die sich über drei verschiedene Strukturbereiche erstrecken.
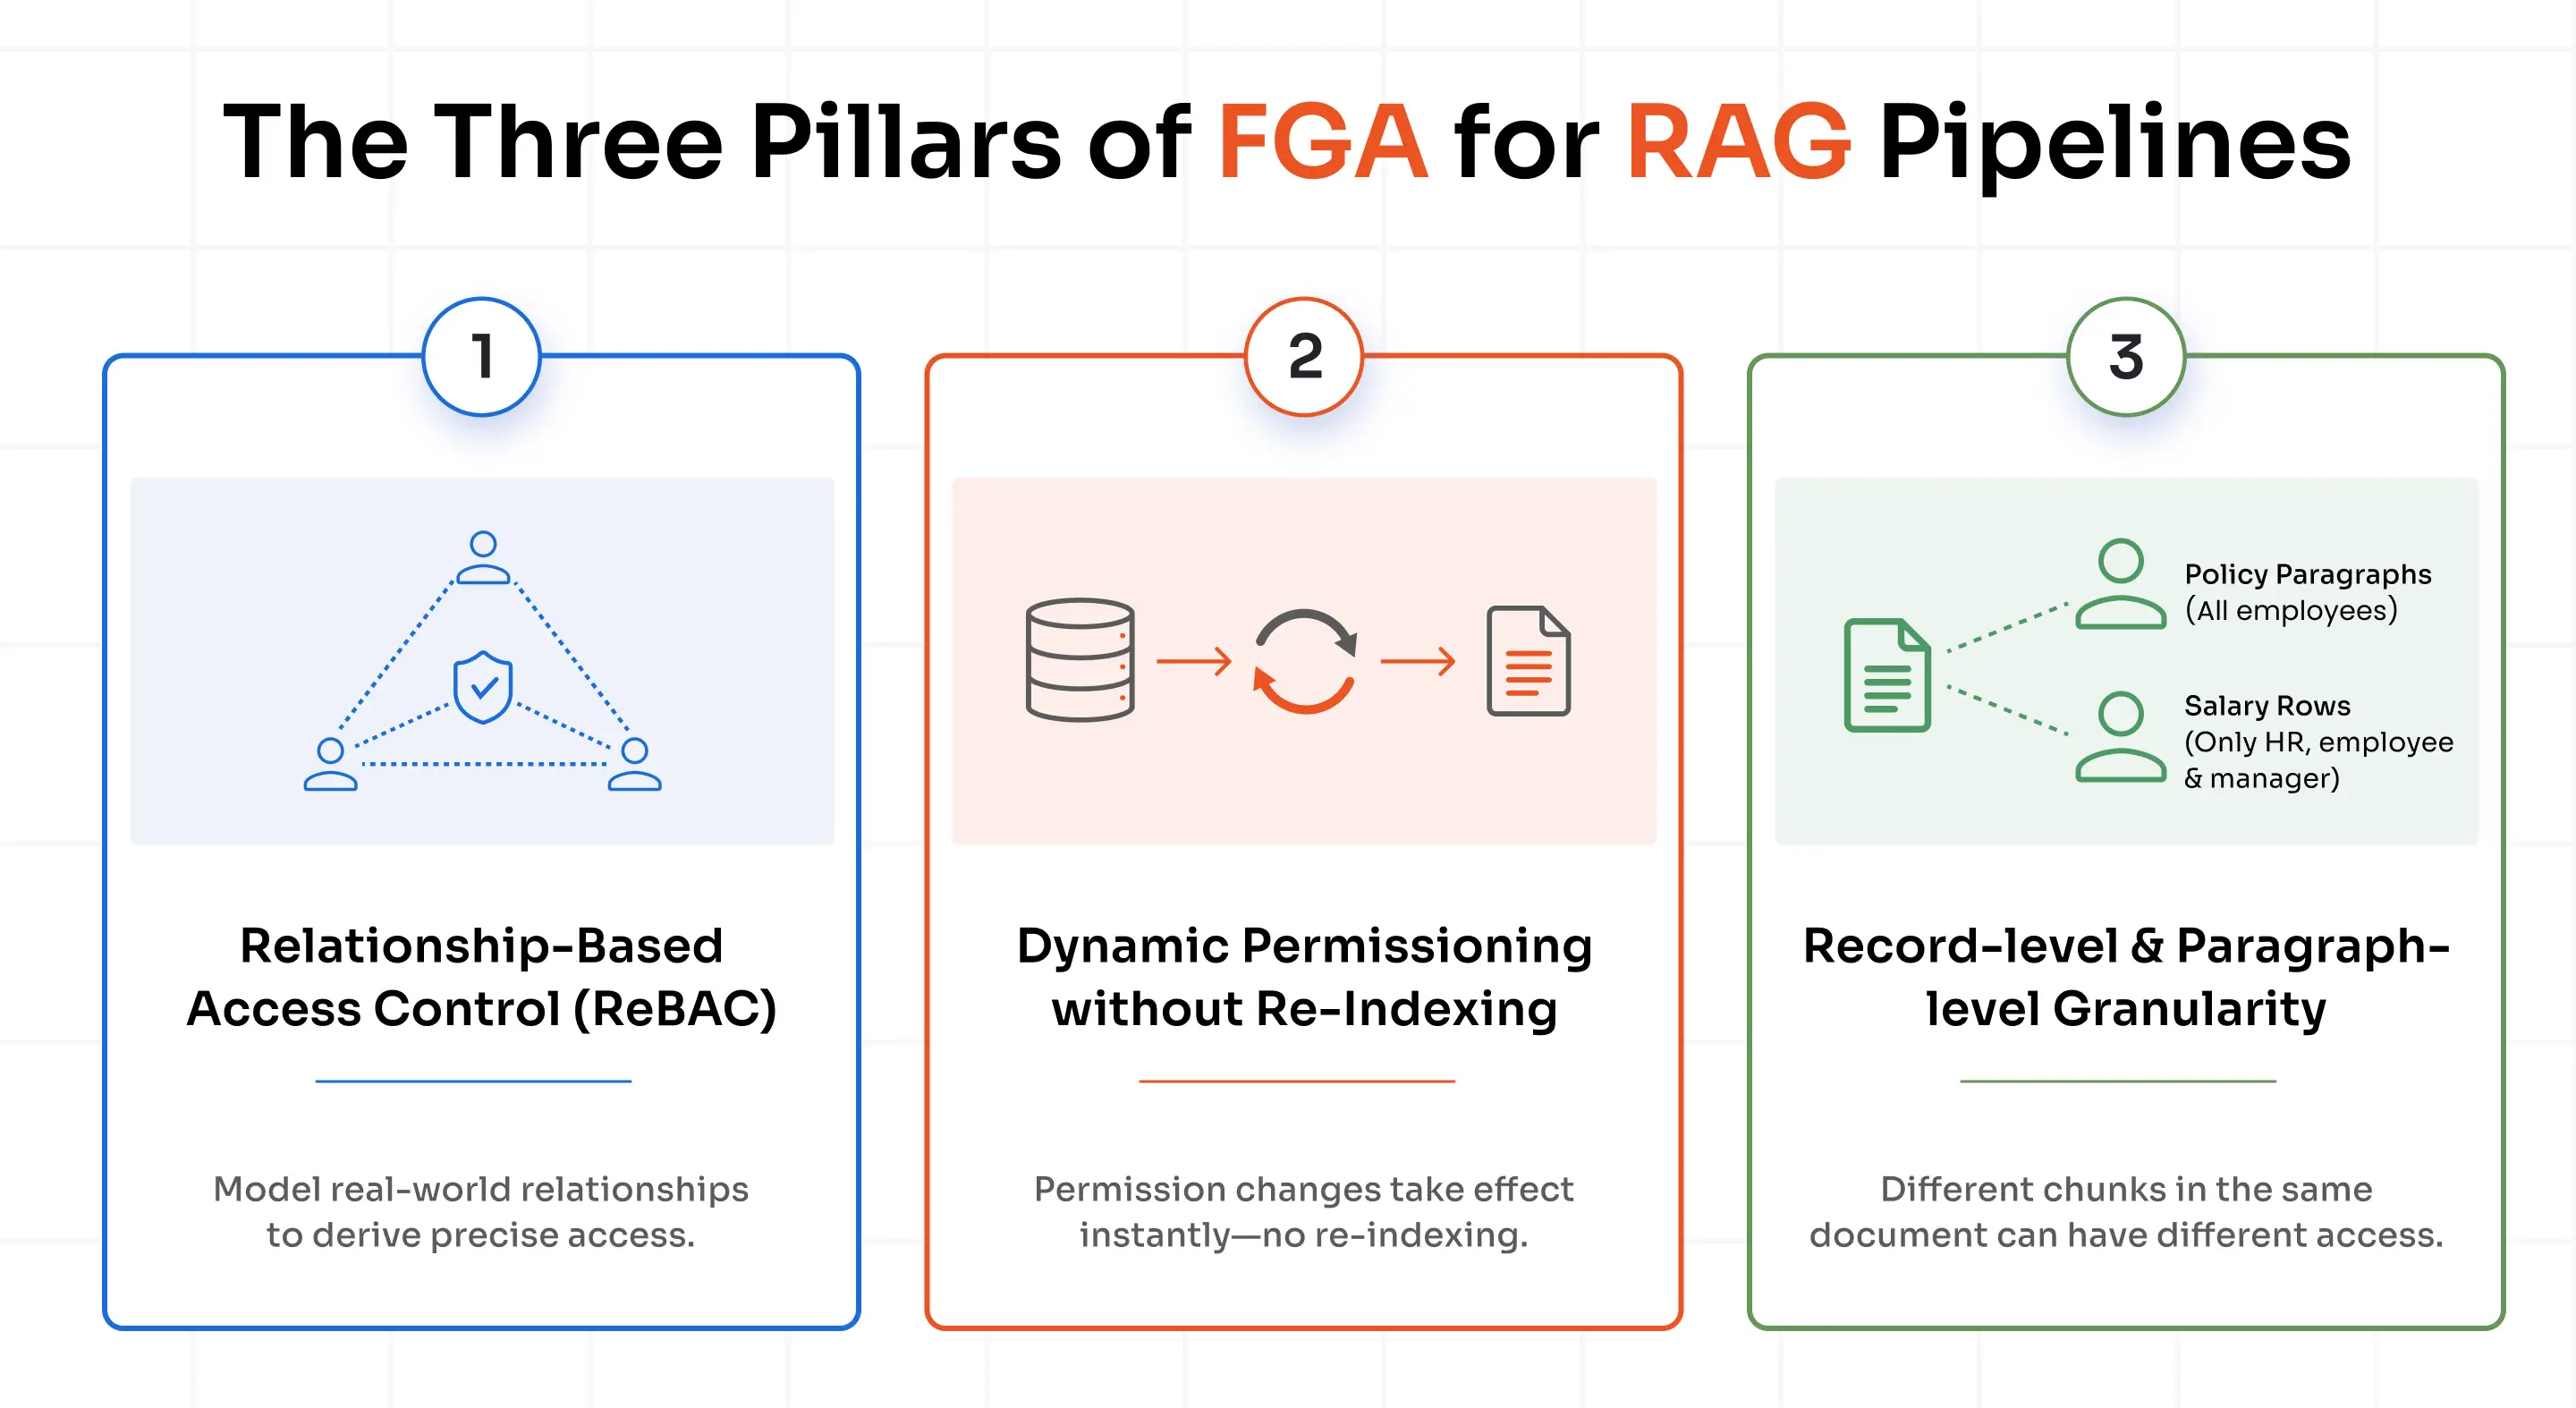
Säule 1: Beziehungsbasierte Zugriffskontrolle (ReBAC)
Das beziehungsbasierte Zugriffskontrollmodell (ReBAC) ist das spezifische Autorisierungsmodell, das eine feingranulare Kontrolle für komplexe Unternehmensumgebungen praktikabel macht.
Anstatt zu versuchen, flache Berechtigungen direkt Tausenden von Benutzern zuzuordnen, modelliert ReBAC den Zugriff als gerichteten Graphen realer Beziehungen, die Benutzer, Objekte und Organisationsgruppen miteinander verbinden.
Im RAG-Format sehen Beziehungen folgendermaßen aus:
- Einem Mitarbeiter gehört seine Gehaltszeile.
- Ein Manager leitet seine direkt unterstellten Mitarbeiter.
- Der Manager erbt die Berechtigung, die Zeilen dieser Berichte zu lesen.
- Die Personalabteilung verwaltet die Gehaltsabrechnung.
- Die Personalabteilung erbt die Berechtigung, alle Zeilen zu lesen.
Bei der Auswertung einer Abfrage durch die RAG-Pipeline muss nicht geprüft werden, ob ein Datenblock sicher ist. Der Autorisierungsdienst prüft, ob der Benutzer einen gültigen Beziehungspfad zu diesem Datenblock besitzt. Ist dies der Fall, kann der Datenblock abgerufen werden. Andernfalls wird er ausgeschlossen, bevor er den LLM erreicht.
Das ist der Ansatz, der aus Googles Zanzibar-Paper stammt: Berechtigungen werden aus Beziehungen abgeleitet, was sie präziser und skalierbarer macht als flache Zugriffslisten.
Säule 2: Dynamische Berechtigungsvergabe ohne Neuindizierung
Eine wesentliche operative Hürde bei der Sicherung moderner Vektordatenbanken besteht darin, dass das erneute Einbetten und Indizieren von Textdaten rechenintensiv und zeitaufwendig ist. Bei älteren Sicherheitskonfigurationen erfordert die Änderung der Zugriffsrechte auf ein Dokument die Aktualisierung und erneute Verarbeitung der Metadaten-Tags im gesamten Vektorindex.
FGA löst dieses Problem, indem es Berechtigungsregeln vollständig von den zugrunde liegenden Vektordaten trennt. Da Zugriffsprüfungen durch Abfrage des aktuellen Beziehungsgraphen zum Abrufzeitpunkt erfolgen, werden Berechtigungsanpassungen sofort wirksam.
Das ist in alltäglichen Situationen wichtig:
- Verlässt ein Mitarbeiter das Unternehmen, wird sein Eintrag in der Gehaltstabelle gelöscht. Die nächste Abfrage blockiert diesen Eintrag sofort.
- Ein Manager wird befördert, wodurch sich seine Beziehungen zu den direkt unterstellten Mitarbeitern erweitern. Seine Sichtbarkeit ändert sich, ohne dass die Vektordatenbank verändert werden muss.
- Ein Dokument wird als vertraulich neu eingestuft, daher wird der Richtliniengraph aktualisiert. Alle zukünftigen Abrufe berücksichtigen die neue Regel sofort.
Dies ist ein wesentlicher Vorteil, da die Abfrageschicht so an den aktuellen Geschäftsregeln und nicht an veralteten Indexmetadaten ausgerichtet bleibt. Eine erneute Einbettung oder Indizierung ist nicht erforderlich. Die Vektordatenbank bleibt unverändert, während die Autorisierungsschicht die neue Entscheidung zur Abfragezeit durchsetzt.
Für Enterprise-RAG ist diese Trennung das, was das System wartbar macht.
Säule 3: Granularität auf Datensatz- und Absatzebene
Die herkömmliche Autorisierung erfolgt üblicherweise auf Datei- oder Ordnerebene. Für die KI-gestützte Suche ist dies zu grob. Ein einzelnes Dokument kann sowohl sichere, allgemein teilbare Inhalte als auch sensible Fragmente enthalten, die nur von wenigen Personen eingesehen werden sollten. FGA löst dieses Problem, indem es Fragmente als gleichberechtigte Zugriffsobjekte behandelt.
Nehmen wir ein Dokument mit den Vergütungsrichtlinien. Es kann die Gehaltsphilosophie des Unternehmens enthalten, die für alle Mitarbeiter einsehbar sein sollte. In derselben Datei können auch detaillierte Gehaltsangaben nach Mitarbeitername und -stufe enthalten sein, die nur für die Personalabteilung, den jeweiligen Mitarbeiter und dessen Vorgesetzten sichtbar sein sollten.
Durch die fein abgestufte Durchsetzung können diese Abschnitte innerhalb desselben Quelldokuments unterschiedliche Berechtigungen haben:
- Richtlinienabschnitte: für alle Mitarbeiter zugänglich
- Gehaltszeilen: Nur für die Personalabteilung, den Mitarbeiter und den Manager zugänglich.
Dies ist der praktische Nutzen einer feingranularen Zugriffskontrolle bei der Implementierung von KI . Das RAG-System kann weiterhin nützliche Fragen zu Richtlinien, Leistungen oder Vergütungsgruppen beantworten, ohne private Zeilen preiszugeben. Das LLM sieht niemals unautorisierte Datenblöcke und kann diese daher weder offenlegen, zitieren noch in seine Antwort einbeziehen.
Das ist der Unterschied zwischen sicherem Abrufen des Kontextes und versehentlicher Offenlegung.
Das Problem der KI-Agentenidentität – Wer stellt eigentlich die Abrufanfrage?
Bisher haben wir die feingranulare Autorisierung (FGA) aus der Perspektive eines menschlichen Benutzers betrachtet, der ein RAG-System abfragt. Das ist jedoch nur ein Teil des Sicherheitsmodells.
In einem agentenbasierten Workflow kann der eigentliche Anfragende ein nicht-menschlicher Akteur sein, wie beispielsweise ein LLM oder ein autonomer KI-Agent, der Dokumente durchsuchen, Tools aufrufen, Aufgaben verketten und über mehrere Schritte hinweg Daten abrufen kann.
Dies führt zu einer umfassenderen Herausforderung hinsichtlich der Identität von KI-Agenten . Das System beantwortet nicht mehr nur die Frage: „Hat dieser Benutzer Zugriff?“, sondern auch: „Was darf dieser Agent selbstständig tun?“ und „Welche Berechtigungen hat der menschliche Benutzer ihm übertragen?“ Diese beiden Fragen sind nicht identisch, und ihre Gleichsetzung birgt unnötige Risiken.
Das korrekte Muster ist die delegierte Autorisierung, auch bekannt als „im Auftrag von“-Autorisierung. Der Agent sollte kein allgemeines Token erhalten, das die gesamte Vektordatenbank freischaltet. Stattdessen sollte das System beide Identitäten weitergeben: die eigene Identität des Agenten und die des delegierenden Benutzers. Dies ist eine entscheidende Voraussetzung für die sichere Implementierung einer feingranularen Zugriffskontrolle in KI- Systemen.
Die Autorisierungsentscheidung basiert auf der Schnittmenge dieser beiden Berechtigungsbereiche. In der Praxis bedeutet dies, dass der Agent nur auf Daten zugreifen kann, auf die beide Identitäten Zugriff haben. Dieser Ansatz erweitert die FGA für RAG über menschliche Benutzer hinaus und stellt sicher, dass autonome Agenten an dieselben Autorisierungsgrenzen gebunden bleiben wie die Personen, die sie repräsentieren.
„Ein KI-Agent sollte niemals mehr Zugriffsrechte haben als der Mensch, der ihn aufgerufen hat. Die delegierte Autorisierung stellt dies auf der Abrufebene sicher.“
Wie eine sichere RAG-Architektur von Anfang bis Ende aussieht
Eine sichere RAG-Architektur basiert auf drei voneinander unabhängigen Kontrollmechanismen: Authentifizierung, Autorisierung und Auditierbarkeit. Fehlt eine dieser Ebenen, können sensible Daten dennoch in das Kontextfenster des LLM gelangen.
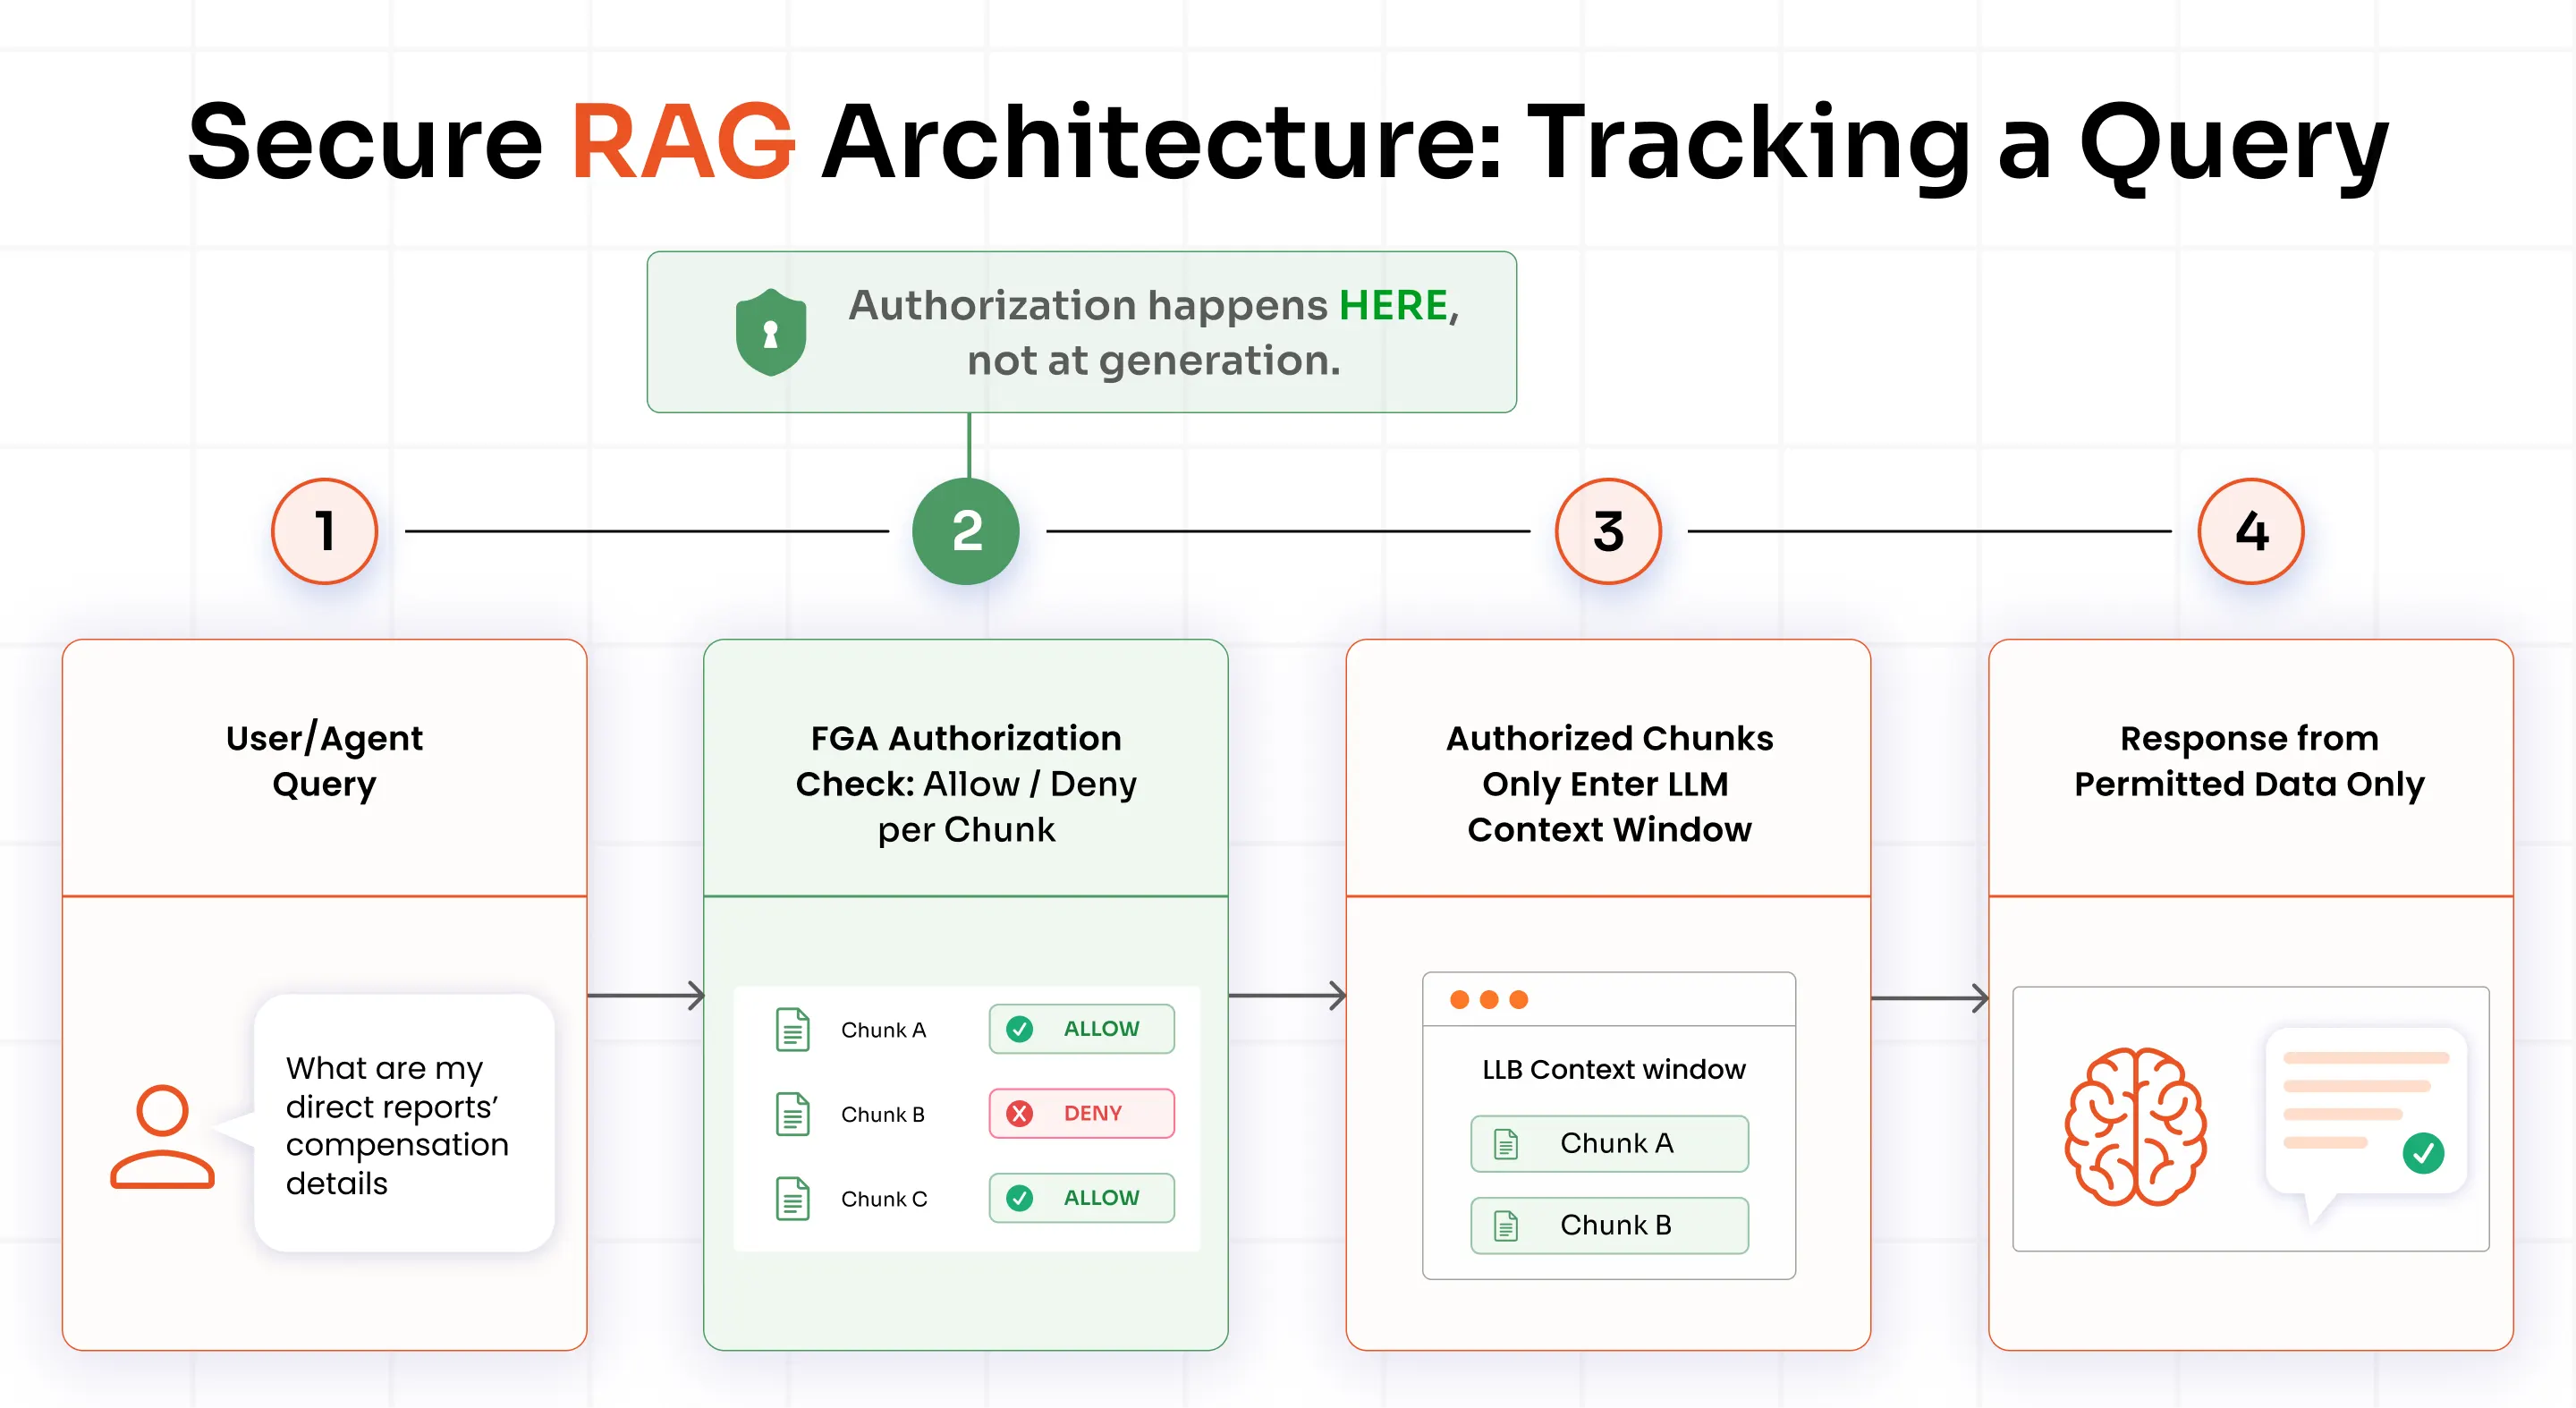
1. Authentifizierung: Jede Abrufanfrage muss eine verifizierte Identität enthalten.
Jede Abrufanfrage sollte mit einer verifizierten Identität verknüpft sein, unabhängig davon, ob der Anfragende ein menschlicher Benutzer, ein KI-System oder beides ist. Langlebige API-Schlüssel und statische Servicekonten stellen ein hohes Risiko dar, da sie einen umfassenden, dauerhaften Zugriff ermöglichen, der nicht mit der Identität des Anfragenden verbunden ist.
Moderne RAG-Architekturen ersetzen statische Anmeldeinformationen durch Workload-Identitäten und kurzlebige Anmeldeinformationen. Technologien wie OAuth 2.1, SPIFFE/SVID und mTLS ermöglichen es Agenten, sich sicher zu authentifizieren und temporäre Token zu erhalten, die auf eine bestimmte Sitzung beschränkt sind.
Dadurch kann das System bei Zugriffsentscheidungen sowohl die Identität des Agenten als auch die Identität des delegierenden Benutzers auswerten und so sicherstellen, dass die Autorisierung an den tatsächlichen Anfragenden und nicht an ein generisches Dienstkonto gebunden bleibt.
2. Feingranulare Autorisierung zum Zeitpunkt des Abrufs
Die Authentifizierung beantwortet die Frage: „Wer stellt die Anfrage?“ Der FGA-Dienst beantwortet eine andere Frage: „Worauf darf diese Identität zugreifen?“
Bevor ein Dokumentabschnitt in das Kontextfenster des LLM gelangt, sendet die RAG-Pipeline drei Eingaben an den FGA-Autorisierungsdienst:
- Identität des Antragstellers
- Ressourcen-ID des Kandidaten-Chunks
- Die angeforderte Aktion (typischerweise gelesen)
Der Dienst wertet die relevanten Beziehungen und detaillierten Autorisierungsrichtlinien der jeweiligen Ressource aus und gibt für jeden Datenblock eine Zulassungs- oder Ablehnungsentscheidung zurück. Nur autorisierte Datenblöcke werden an den LLM weitergeleitet.
Diese Autorisierungsprüfung vor dem Abruf ist die wichtigste Sicherheitsmaßnahme der Architektur. Sie ist kein Eingabeaufforderungsfilter, Ausgabefilter oder Generierungsschutzmechanismus. Sie stellt eine feste Grenze dar, die festlegt, auf welche Daten das Modell überhaupt zugreifen darf.
3. Audit-Protokollierung: Nachweiskette für jeden Kontextabschnitt
Jede Autorisierungsentscheidung sollte protokolliert werden. Dies umfasst jeden abgerufenen Datenblock, jeden blockierten Datenblock und die an jeder Entscheidung beteiligten Identitäten.
Dadurch entsteht eine lückenlose Nachverfolgbarkeit der Daten, die den KI-Antworten zugrunde liegen. Sicherheitsteams können genau nachvollziehen, welche Datenblöcke in den Kontext gelangten, warum der Zugriff gewährt wurde und welche Identität die Anfrage initiiert hat.
Mit dem zunehmenden Einsatz von KI in regulierten Umgebungen gewinnt diese Transparenz immer mehr an Bedeutung, um die Einhaltung von DSGVO, HIPAA, SOC 2 und dem indischen Datenschutzgesetz (DPDPA) nachzuweisen. Es reicht nicht mehr aus, nur die KI-Ergebnisse zu verstehen. Unternehmen müssen auch belegen können, welche spezifischen Datenquellen zu diesen Ergebnissen beigetragen haben.
Wie miniOrange FGA für RAG-Pipelines implementiert
Wenn Sie im Jahr 2026 die besten Lösungen für die feingranulare Autorisierung evaluieren , implementiert miniOrange FGA für RAG- Pipelines durch eine Kombination aus beziehungsbasierten Autorisierungsrichtlinien und Echtzeit-Berechtigungsauswertung auf der Abrufebene.
Der Ansatz zielt darauf ab, die zentrale Herausforderung zu bewältigen, die in diesem Artikel immer wieder diskutiert wird: sicherzustellen, dass die Relevanz nicht die Autorisierung außer Kraft setzt.
Zu den wichtigsten Funktionen gehören:
- Autorisierung pro Dokument und pro Datenblock Das Verfahren wertet Berechtigungen auf der Ebene einzelner Dokumentfragmente aus, anstatt eine gesamte Datei oder einen Ordner als eine einzige Zugriffsgrenze zu behandeln.
- ReBAC-Politikmodellierung Das stellt Beziehungen zwischen Benutzern, Gruppen, Rollen und Ressourcen als Graph dar und ermöglicht so die Vererbung von Berechtigungen für gängige Geschäftsszenarien, wie beispielsweise den Zugriff von Managern auf Teams.
- Echtzeit-Berechtigungsauswertung wobei Autorisierungsentscheidungen für jede Anfrage und jeden Kandidaten-Chunk getroffen werden, bevor die Abrufergebnisse an das Modell übergeben werden.
- Delegierte Autorisierung für KI-Agenten, wodurch umfassendere Anforderungen an die Autorisierung von KI-Agenten unterstützt werden, indem die Schnittmenge von Benutzerberechtigungen und Agentenberechtigungen während des Abrufs durchgesetzt wird.
- Sofortiger Berechtigungsentzug das Zugriffsentscheidungen sofort aktualisiert, ohne dass eine Neuindizierung der Vektordatenbank oder eine erneute Dokumentenverarbeitung erforderlich ist.
- Compliance-Prüfprotokolle die die anfragende Identität, die Ressourcenkennung, das Autorisierungsergebnis und den Zeitstempel für jede Abrufentscheidung aufzeichnen.
Durch die Kombination von Authentifizierung, beziehungsbasierter Autorisierung und Durchsetzung in Abrufzeit unterstützt miniOrange Unternehmen bei der Implementierung einer fein abgestuften Zugriffskontrolle für KI- Systeme und reduziert gleichzeitig das Risiko einer unautorisierten Datenoffenlegung in unternehmensweiten RAG-Umgebungen.
Fazit: Relevanz ist nicht gleichbedeutend mit Erlaubnis.
Ampelsysteme liefern Mehrwert, indem sie die relevantesten Informationen für eine bestimmte Anfrage finden. Das Problem besteht darin, dass Relevanz und Berechtigung zwei völlig unterschiedliche Konzepte sind. Eine Gehaltsübersicht kann zwar für eine Frage zum Gehalt hochrelevant sein, das bedeutet aber nicht, dass jeder Mitarbeiter darauf zugreifen können sollte.
Hier wird eine fein abgestufte Autorisierung unerlässlich. Durch die Auswertung von Berechtigungen vor dem Abruf stellt FGA sicher, dass nur autorisierte Dokumentabschnitte in das Kontextfenster des LLM gelangen. In Kombination mit ReBAC können Organisationen Zugriffsrichtlinien auf Basis realer Beziehungen durchsetzen, während die dynamische Berechtigungsverwaltung gewährleistet, dass Änderungen sofort wirksam werden, ohne die zugrunde liegende Vektorinfrastruktur zu beeinträchtigen.
Das Leck in der Gehaltsabrechnung ist kein Einzelfall, sondern die natürliche Folge eines Ampelsystems, das Daten ausschließlich anhand semantischer Ähnlichkeit abruft. Da Unternehmen KI für immer sensiblere Datensätze einsetzen, wird eine feingranulare Zugriffskontrolle in KI- Architekturen zu einer grundlegenden Sicherheitsanforderung und nicht mehr zu einer optionalen Erweiterung.
Häufig gestellte Fragen
Worin besteht der Unterschied zwischen FGA und RBAC?
RBAC (Rollenbasierte Zugriffskontrolle) vergibt Berechtigungen basierend auf übergeordneten Rollen wie Mitarbeiter, Manager oder Personaladministrator. Dies funktioniert gut, wenn alle Personen innerhalb einer Rolle die gleichen Zugriffsrechte benötigen. RAG-Systeme (Anzahl der adressierten Elemente) stellen eine andere Herausforderung dar, da Zugriffsentscheidungen oft auf Dokumenten-, Datensatz- oder Datenbereichsebene getroffen werden müssen. FGA (Feingranulare Autorisierung) prüft anhand von Beziehungen und Kontext, ob ein bestimmter Benutzer auf eine bestimmte Ressource zugreifen darf. Beispielsweise kann ein Manager Gehaltsinformationen seiner direkten Mitarbeiter einsehen dürfen, nicht aber die von Mitarbeitern anderer Teams. Dadurch ist FGA deutlich effektiver als RBAC für die Steuerung des Datenabrufs in KI-Systemen.
Was ist ReBAC (Relationship-Based Access Control)?
Beziehungsbasierte Zugriffskontrolle (ReBAC) ist das Autorisierungsmodell, das vielen modernen , fein abgestuften Autorisierungssystemen zugrunde liegt . Anstatt Berechtigungen über statische Rollen oder Zugriffslisten zuzuweisen, bestimmt ReBAC den Zugriff anhand der Beziehungen zwischen Benutzern und Ressourcen. Beispielsweise kann ein Mitarbeiter Eigentümer eines Dokuments sein, während sein Vorgesetzter über die Managementbeziehung Zugriff darauf erhält. Dieser Ansatz erleichtert die Modellierung realer Zugriffsmuster, die sich im Laufe der Zeit ändern. Für RAG-Systeme ist ReBAC besonders effektiv, da Dokumentenbesitz, Berichtswege, Projektzugehörigkeiten und Freigaberegeln oft zu komplex sind, um allein durch traditionelle RBAC abgebildet zu werden.
Verlangsamt FGA die RAG-Abfrage?
Bei korrekter Implementierung verursacht ein FGA-Dienst für Unternehmen nur minimale Latenz und benötigt typischerweise weniger als 5 Millisekunden pro Abfrage. Die Autorisierungsprüfung läuft üblicherweise parallel oder unmittelbar nach der Vektorähnlichkeitssuche und bestimmt, welche Datenblöcke für den Kontext des LLM zugelassen sind. Der geringe Mehraufwand ist im Vergleich zu den Sicherheits- und Compliance-Risiken, die durch die Offenlegung sensibler Informationen aufgrund unautorisierten Abrufs entstehen, vernachlässigbar.
Muss die Vektordatenbank bei einer Änderung der Berechtigungen von FGA neu indiziert werden?
Nein. Einer der größten Vorteile von FGA ist die separate Verwaltung von Berechtigungen und Vektoreinbettungen. Ändert sich der Zugriff eines Benutzers beispielsweise durch eine Beförderung, eine Projektumstrukturierung oder das Ausscheiden aus dem Unternehmen, muss lediglich der Beziehungsgraph aktualisiert werden. Dokumente, Einbettungen und Vektorindex bleiben unverändert. Die nächste Abfrage berücksichtigt automatisch die aktualisierten Berechtigungen. So können Unternehmen die Zugriffskontrolle in Echtzeit durchsetzen, ohne bei jeder Änderung der Autorisierungsregeln Daten neu indizieren oder einbetten zu müssen.
Worin besteht der Unterschied zwischen der Autorisierungsfilterung vor dem Abruf und der Filterung nach der Generierung?
Die Autorisierung vor dem Abruf wendet Zugriffskontrollen an, bevor Dokumentfragmente an das LLM übergeben werden. Ist ein Benutzer nicht berechtigt, auf ein Fragment zuzugreifen, gelangt dieses nicht in das Kontextfenster des Modells. Die Filterung nach der Generierung verfolgt einen anderen Ansatz, indem sie die Antwort des Modells prüft, nachdem diese bereits generiert wurde. Die Herausforderung besteht darin, dass das LLM möglicherweise bereits unautorisierte Informationen zur Gestaltung seiner Antwort verwendet hat, selbst wenn der ursprüngliche Inhalt später entfernt wird. Daher ist eine fein abgestufte Autorisierung am effektivsten, wenn sie vor dem Abruf erzwungen wird, bevor sensible Daten das Modell erreichen.
Welche Compliance-Rahmenwerke erfordern FGA für RAG?
Kein etabliertes Compliance-Framework schreibt eine differenzierte Autorisierung für RAG-Systeme explizit vor. Allerdings verpflichten Vorschriften wie die DSGVO, HIPAA, SOC 2 und das indische DPDPA Unternehmen zur Implementierung geeigneter Zugriffskontrollen und zur Beschränkung des Zugriffs auf sensible Daten auf das Notwendigste. Ein RAG-System, das Daten ausschließlich anhand ihrer Relevanz abruft, kann Informationen offenlegen, die über den autorisierten Bereich eines Benutzers hinausgehen. FGA trägt zur Risikominimierung bei, indem es Zugriffsentscheidungen auf Dokumenten-, Datensatz- und Chunk-Ebene durchsetzt und somit die von diesen Frameworks geforderten Prinzipien der Datenminimierung und Zugriffskontrolle unterstützt.



Hinterlasse einen Kommentar