

KI-Agenten werden rasant von Pilotprojekten in den Produktiveinsatz überführt. Laut der KI-Agenten-Studie von PwC setzen bereits 79 % der Führungskräfte KI-Agenten in ihren Unternehmen ein.
Sobald Agenten APIs aufrufen, Daten abrufen, Tools koordinieren und systemübergreifend agieren, stellt sich nicht mehr die Frage nach ihrer Nützlichkeit, sondern ob jeder Agent seine Identität, seine Berechtigungen und die Gültigkeitsdauer dieser Berechtigungen nachweisen kann.
Deshalb wird die Workload-Identität für KI-Agenten zu einem zentralen Bestandteil moderner Sicherheitsstrategien. Für Unternehmen, die aufbauen IAM Für agentenbasierte KI birgt das alte Muster gemeinsam genutzter Servicekonten, statischer API-Schlüssel und langlebiger Token unnötige Risiken, eine schwache Überprüfbarkeit und ein mangelhaftes nicht-menschliches Identitätsmanagement.
In der Praxis agieren KI-Agenten heute als gleichberechtigte Akteure neben Menschen und Software-Workloads in Unternehmenssystemen. Diese Entwicklung macht Workload-Identitätsmanagement, Maschinenidentitätssicherheit und Zugriffskontrolle für KI-Agenten zu grundlegenden, nicht optionalen Funktionen.
Die Lücke bei der KI-Authentifizierung wird immer schwerer zu ignorieren.
Human IAM Es wurde für Active Directory, Benutzerlebenszyklen und vorhersehbare Zugriffsmuster entwickelt. KI-Agenten verhalten sich anders. Sie können dynamisch erstellt werden, kurzzeitig ausgeführt werden, mehrere Tools aufrufen und mit delegierter Berechtigung in verschiedenen Umgebungen agieren.
Diese Diskrepanz ist der Kern der heutigen KI-Identitätskrise. Wenn Teams Agenten mit statischen Geheimnissen oder gemeinsam genutzten Anmeldeinformationen schützen, verlieren sie die Fähigkeit, Aktionen eindeutig zuzuordnen, den Zugriff präzise einzuschränken und Berechtigungen ohne Kollateralschäden zu widerrufen.
Aus diesem Grund kann agentenbasierte KI-Sicherheit nicht als kleine Erweiterung traditioneller Sicherheitslösungen betrachtet werden. IAMGemäß den jüngsten Updates von MicrosoftJeder Agent muss kontrolliert, beobachtbar und geschützt sein.
Führungskräfte müssen in der Lage sein:
- Beschränkt den Zugriff des Agenten
- Man beachte, dass Agenten dies tun.
- Unterbinden Sie, was Agenten nicht tun dürfen.
- Erstellen Sie eine Bestandsaufnahme der vorhandenen Agenten.
- Prüfen Sie, wem die Agenten gehören.
Eine zentrale Agentensteuerung trägt zu einer einheitlichen Governance bei, unabhängig von Bereitstellung oder Plattform. Darüber hinaus ermöglicht die Workload-Identität die Sicherstellung, auf welche Ressourcen Agenten zugreifen können.
Was ist Workload-Identität?
In der Praxis ist die Workload-Identität eine kryptografische Identität, die einer nicht-menschlichen Recheneinheit wie einem Dienst, Container, einer Funktion, einer virtuellen Maschine (VM) oder einem KI-Agenten zugewiesen wird. Anstatt ein statisches Geheimnis im Code oder in der Konfiguration zu hinterlegen, weist die Workload ihre Identität nach und erhält Zugriff basierend auf Vertrauensrichtlinien und dem Laufzeitkontext.
Dies beinhaltet üblicherweise kurzlebige Anmeldeinformationen, automatische Rotation und richtlinienbasierte Autorisierung. In Cloud-nativen Umgebungen werden häufig offene Standards wie das Secure Production Identity Framework for Everyone (SPIFFE) zur Darstellung der Maschinenidentität verwendet.
Die Repräsentation erfolgt häufig über SPIFFE Verifiable Identity Documents, oder SVIDs, die angeben, um welche Art von Arbeitslast es sich handelt und wo sie ausgeführt wird.
Man kann es sich einfach so vorstellen: Ein API-Schlüssel ist, als würde man jedem Auftragnehmer denselben Generalschlüssel geben und hoffen, dass ihn niemand kopiert. Die Identitätsprüfung für Arbeitslasten ist eher vergleichbar mit der Ausstellung eines zeitlich begrenzten Ausweises, der jeder Person ihre Identität, ihren Platz und ihre Befugnisse bestätigt.
Die drei Akteure der modernen Identität
Die Unternehmensidentität dreht sich heute um drei Hauptakteure:
- Menschen, die typischerweise verzeichnisbasierte Identitäten und stabile Lebenszykluskontrollen verwenden.
- KI-Agenten, die autonom oder halbautonom agieren, oft mit delegierter Autorität und dynamischen Ausführungsmustern.
- Maschinen und Workloads, einschließlich Dienste, Container, Funktionen und Infrastrukturkomponenten, die ebenfalls eine überprüfbare Maschinenidentität benötigen.
Der entscheidende Unterschied besteht darin, dass KI-Agenten oft die Eigenschaften von Software und Entscheidungsträgern vereinen. Sie authentifizieren sich nicht nur einmal und bleiben dann untätig.
Agenten rufen Tools auf, orchestrieren Aktionen und können Berechtigungen erben oder delegiert nutzen. Deshalb benötigt die Authentifizierung von KI-Agenten mehr als ein wiederverwendetes Dienstkonto.
Warum KI-Agenten die Workload-Identifizierung dringlich machen
KI-Systeme erhöhen sowohl den Umfang als auch die Komplexität des nicht-menschlichen Zugriffs. Mit ihrer zunehmenden Verbreitung in den Bereichen Kundensupport, DevOps, interne Abläufe und Entscheidungsunterstützung treten Identitätslücken deutlich zutage.
Hier sind die drei Gründe, warum die Dringlichkeit zunimmt:
1. Die Agenten handeln schnell und mit delegierter Befugnis.
Wenn ein Agent einen Workflow auslösen, ein System abfragen oder im Namen eines Benutzers handeln kann, muss das Unternehmen genau wissen, welcher Agent unter welcher Richtlinie und mit welcher Berechtigungsgrenze gehandelt hat.
2. Agenten sind dynamisch und ephemer.
Im Gegensatz zu vielen menschlichen Benutzern können Agenten und Arbeitslasten schnell erscheinen und wieder verschwinden.
Hier kommen temporäre Zugangsdaten ins Spiel. Wenn der Zugriff nur kurzzeitig gültig ist und automatisch erneuert wird, ist der Schadensradius durchgesickerter Zugangsdaten deutlich geringer als bei einem fest codierten Token, der monatelang gültig ist.
3. Agenten vervielfachen die Authentifizierungsfläche
Ein Mitarbeiter kann eine Identität haben. Ein KI-gesteuerter Prozess kann mehrere Agenten, Tools, APIs, Modellanbieter und nachgelagerte Systeme umfassen.
Dies macht KI-Agenten mit Zero-Trust-Prinzip zu einem realistischeren Designprinzip als implizites Vertrauen. Jeder Anruf sollte anhand von Identität, Kontext und Richtlinien bewertet werden, anstatt anzunehmen, dass alles innerhalb einer vertrauenswürdigen Umgebung sicher ist.
Der Wandel von Geheimnissen zur Workload-Identität
Bei statischen Geheimnissen prüft das System, ob ein präsentierter Schlüssel oder ein Token mit einem gespeicherten Wert übereinstimmt. Dies gibt Aufschluss darüber, ob eine Anmeldeinformation gültig ist, aber nicht immer darüber, ob es sich beim Aufrufer um die beabsichtigte Arbeitslast handelt, ob er in der richtigen Umgebung ausgeführt wird oder ob dieser Zugriff überhaupt noch bestehen sollte.
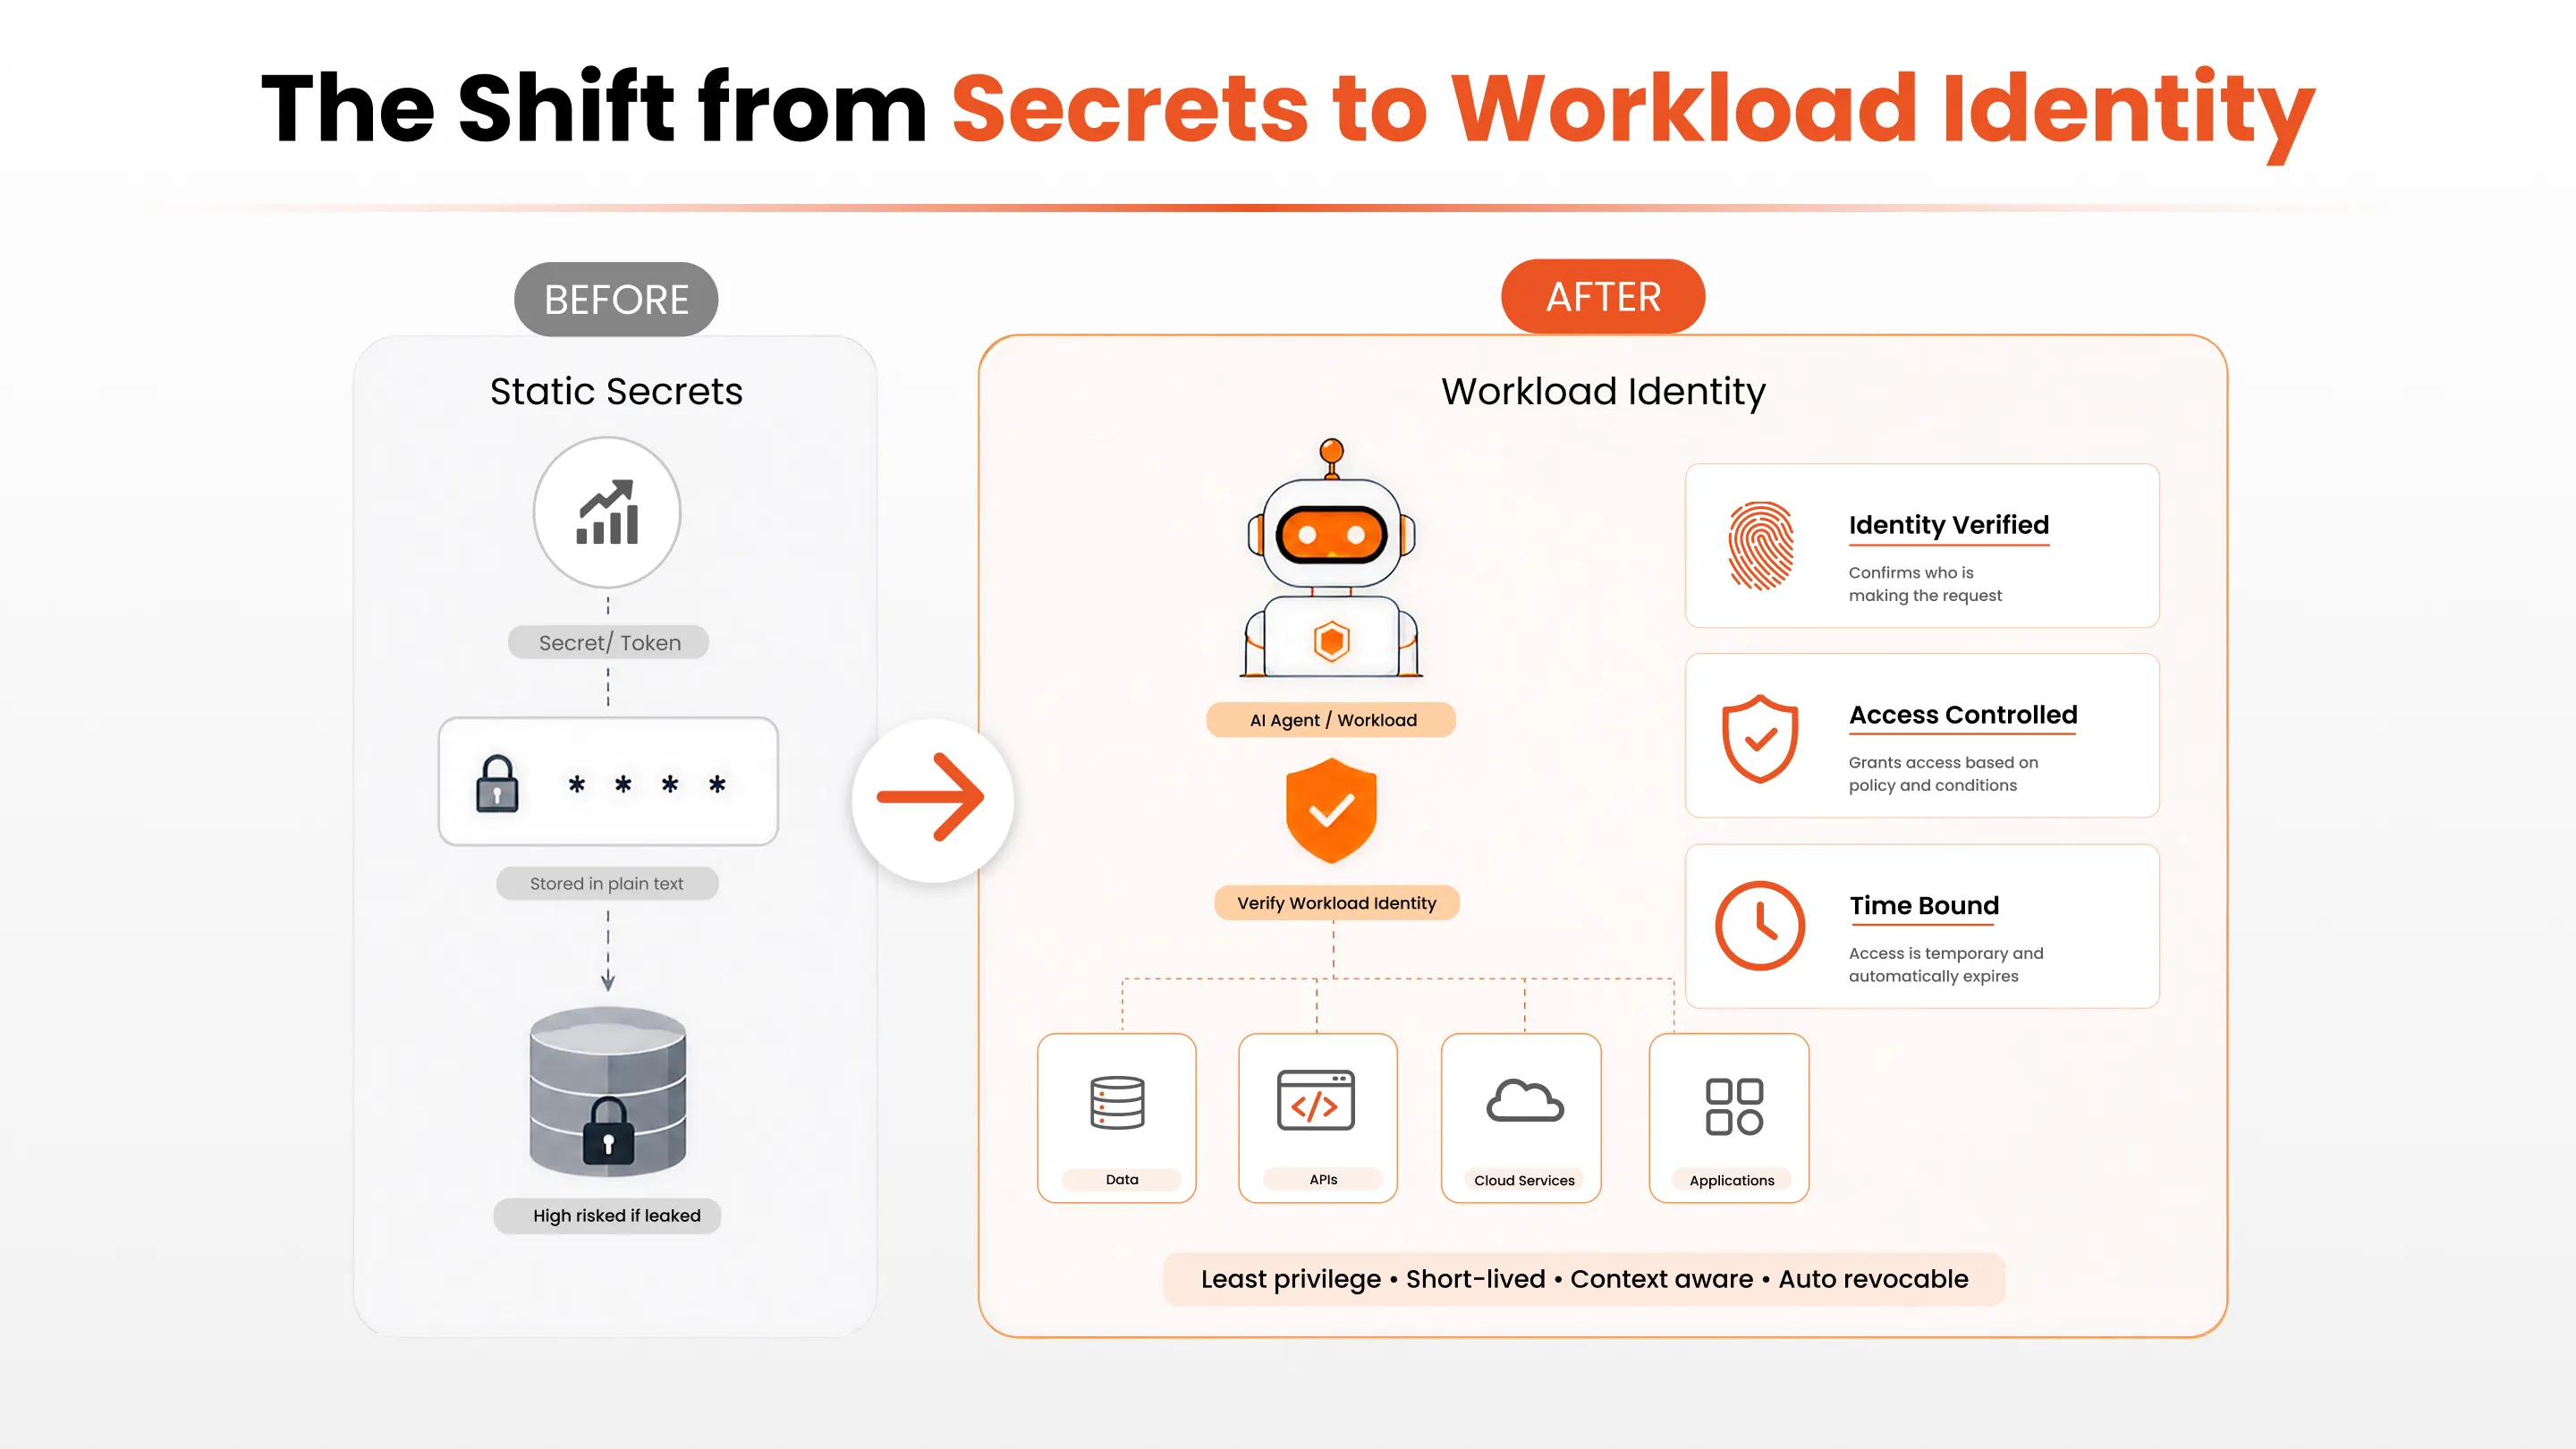
Bei der Workload-Identität geht das System von einer grundlegenderen Frage aus: Welcher Workload stellt diese Anfrage gerade, unter welchen bestätigten Bedingungen und worauf soll er Zugriff erhalten? Das eignet sich wesentlich besser für die Zugriffskontrolle von KI-Agenten und Zero-Trust-KI-Agenten.
Wo passt SPIFFE hinein und wo nicht?
SPIFFE ist einer der wichtigsten Standards für die Workload-Identität, insbesondere in Cloud-nativen Umgebungen. Er bietet ein Framework zur Zuweisung einer standardisierten, kryptografisch verifizierbaren Identität zu Workloads, häufig über SPIFFE-IDs und SVIDs.
Innerhalb interner Plattformen wie Kubernetes, Service Meshes oder interner APIs kann die Identitätsverwaltung nach SPIFFE-Art sehr gut als primärer Vertrauensmechanismus funktionieren. Viele KI-Agenten müssen jedoch auch auf externe SaaS-Tools, Cloud-Dienste und APIs zugreifen, die OAuth erwarten. IAM Tokens oder herstellerspezifische Authentifizierungsmodelle.
Workload-Identität vs. Shared-Service-Konten
Gemeinsam genutzte Servicekonten und Workload-Identität sind beides Möglichkeiten, Software mit anderen Systemen kommunizieren zu lassen, aber sie funktionieren sehr unterschiedlich und weisen sehr unterschiedliche Risikoprofile auf.
Bei gemeinsam genutzten Dienstkonten handelt es sich um nicht-menschliche Konten, deren Anmeldeinformationen von mehreren Anwendungen, Skripten oder Diensten wiederverwendet werden, um auf andere Systeme zuzugreifen.
Bei der Workload-Identität handelt es sich um ein Identitätsmodell, bei dem jeder nicht-menschliche Workload (Anwendung, Container, Skript, KI-Agent, Job usw.) seine eigene überprüfbare, oft kurzlebige Identität erhält, die von einer vertrauenswürdigen Plattform oder einem Identitätsanbieter verwaltet wird.
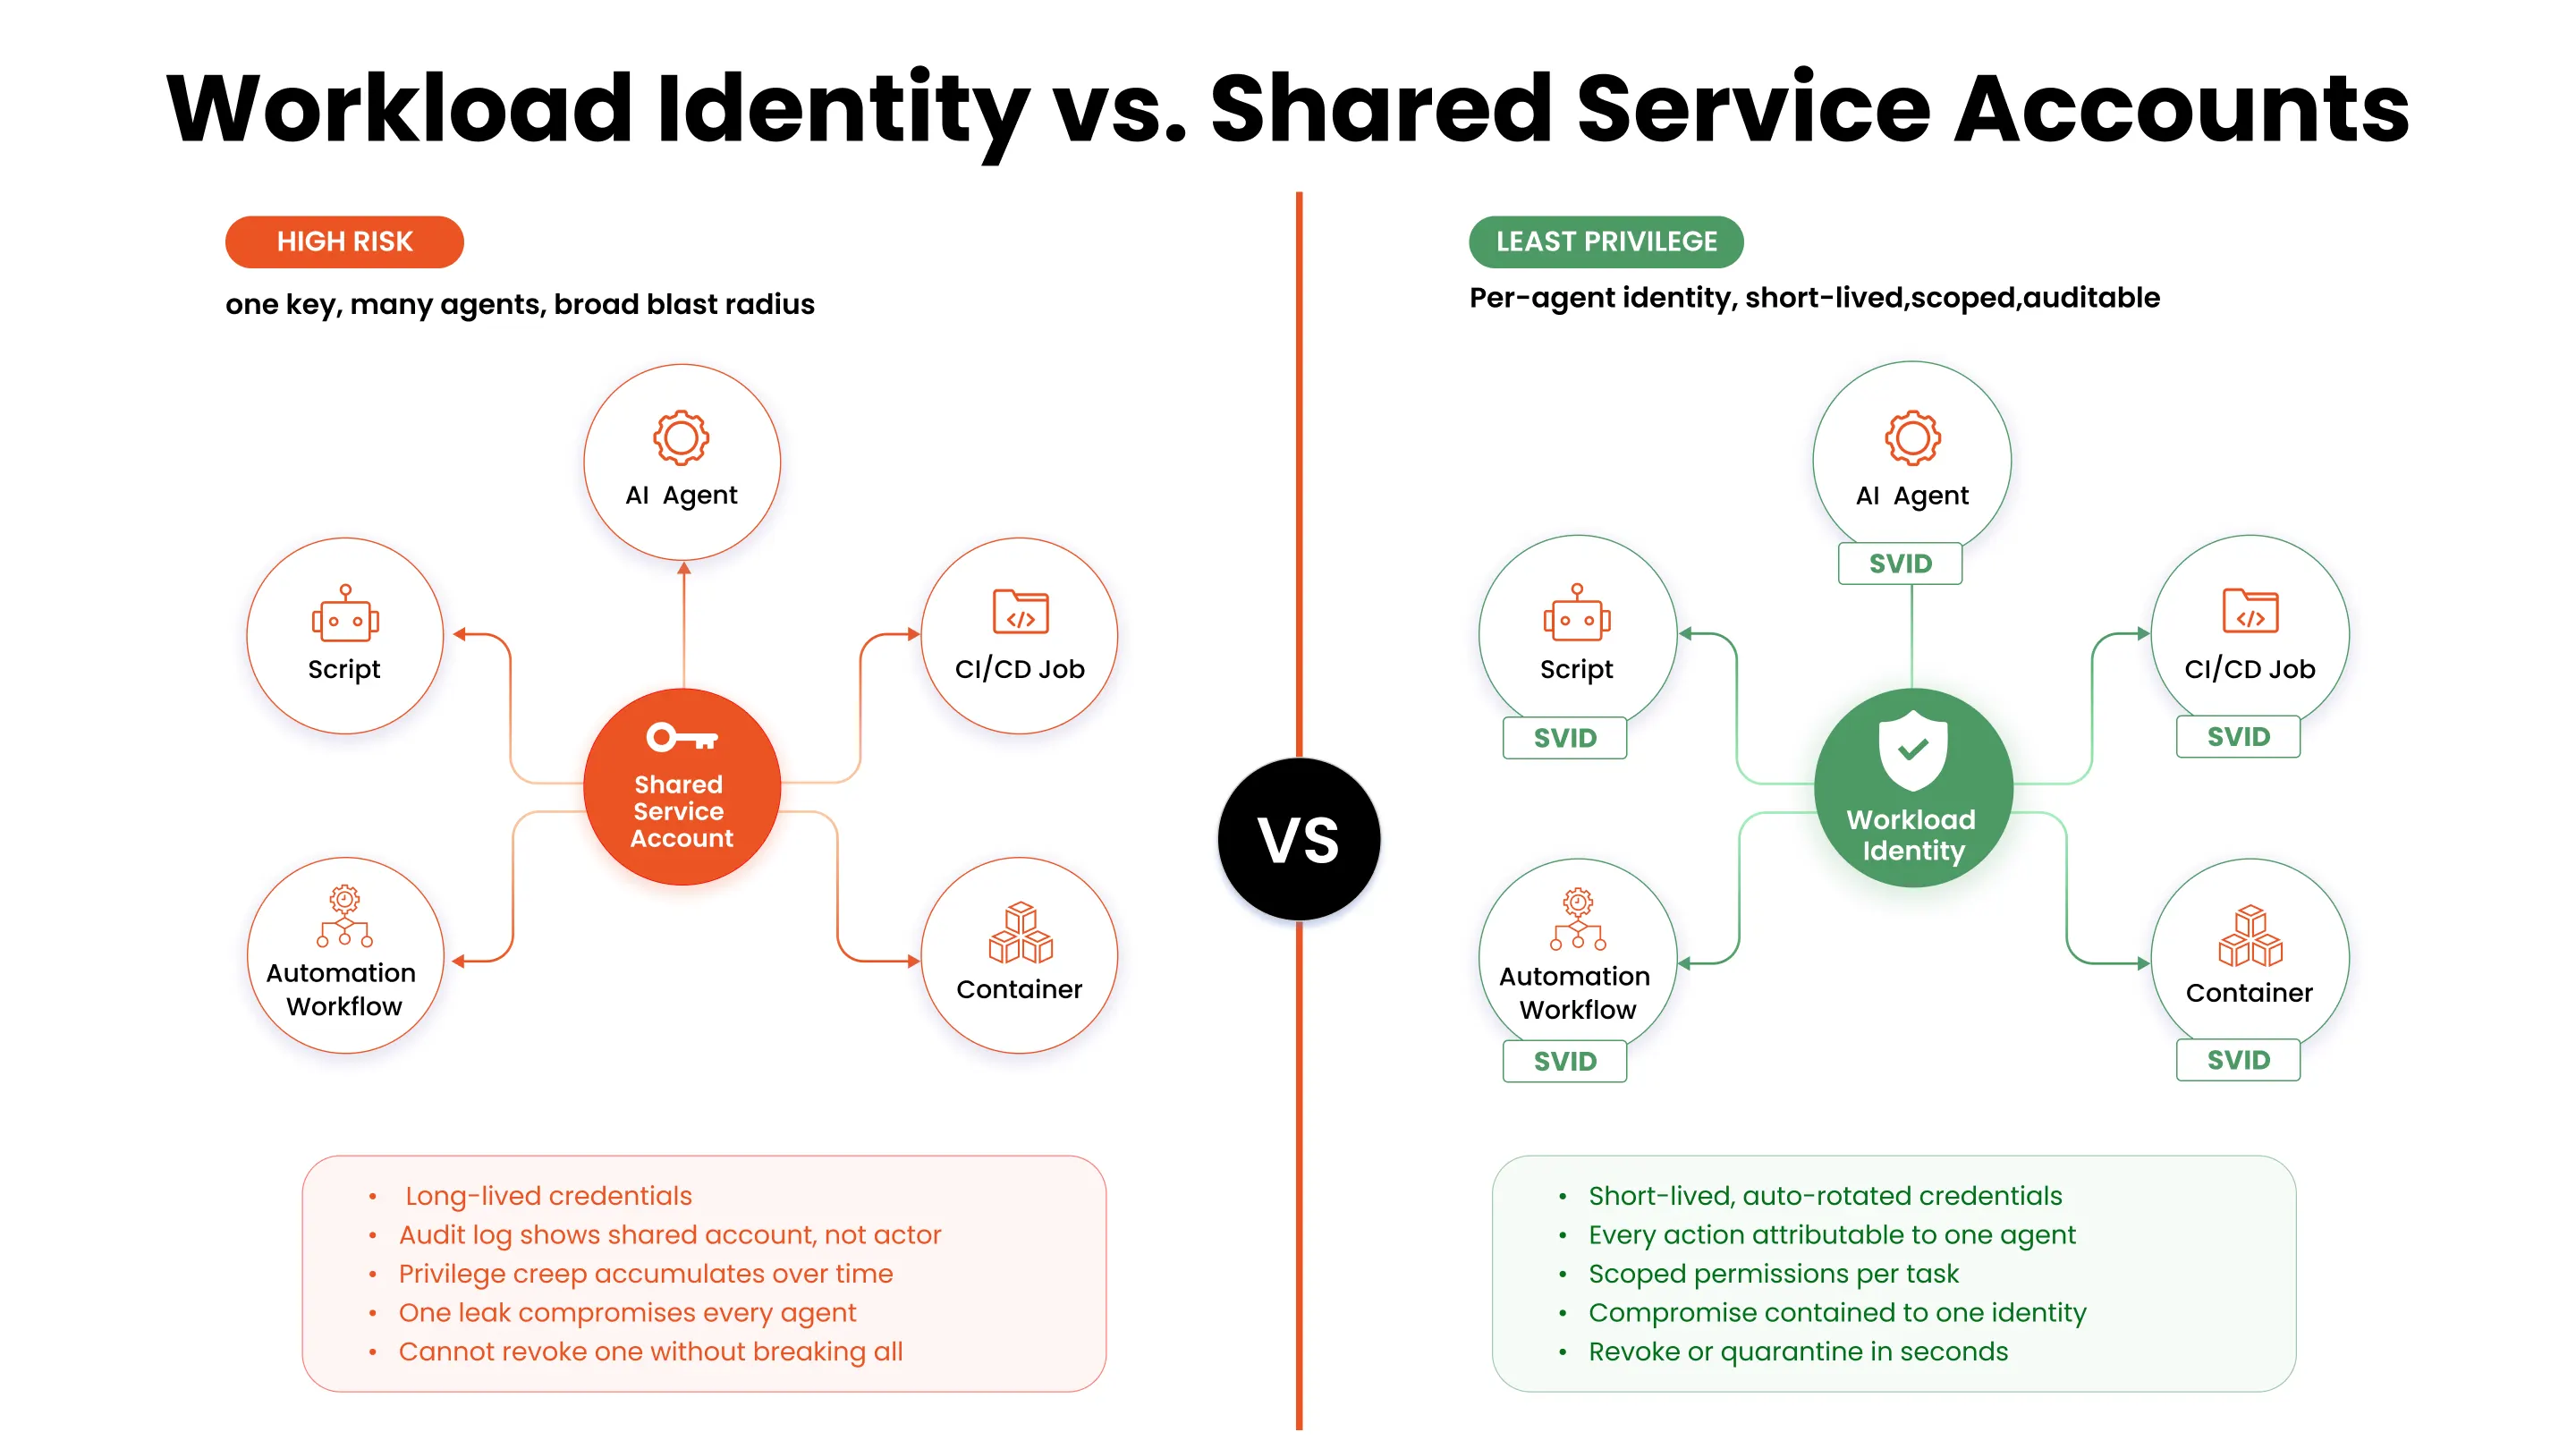
Schauen wir uns nun den vollständigen Vergleich zwischen ihnen an.
| Aspekt | Gemeinsames Servicekonto | Workload-Identität |
|---|---|---|
| Identitätsmodell | Eine Identität, die von mehreren Agenten oder Aufgaben wiederverwendet wird. | Eigene Identität pro Arbeitslast, Agent oder Aufgabe. |
| Explosionsradius | Weitgehend, denn ein einziges durchgesickertes Anmeldeinformationsblatt kann viele Systeme oder Agenten beeinträchtigen. | Eingeschränkt, da der Kompromiss auf eine bestimmte Identität und ein bestimmtes Zeitfenster beschränkt ist. |
| Lebenslange Gültigkeit der Berechtigung | Langlebig und manuell gedreht. | Kurzlebig und automatisch rotierend. |
| Buchungskontrolle | In den Protokollen wird oft das gemeinsam genutzte Konto anstelle des eigentlichen Akteurs angezeigt. | Protokolle können einer bestimmten Agentenidentität zugeordnet werden. |
| Widerruf | Es ist schwierig, eine Einheit auszuschalten, ohne andere zu beeinträchtigen. | Arbeitslasten lassen sich ohne weitreichende Nebenwirkungen einfach widerrufen oder isolieren. |
| Privilegierte Haltung | Hohes Risiko einer schleichenden Ausweitung von Privilegien im Laufe der Zeit. | Besser geeignet für KI mit minimalen Berechtigungen und aufgabenbezogene Autorisierung. |
Gemeinsam genutzte Servicekonten wurden ursprünglich eingeführt, weil sie einfach einzurichten und wiederzuverwenden waren. Das Problem ist jedoch, dass dieser Komfort in verteilten KI-Systemen schlecht skaliert.
Wenn mehrere Agenten eine Identität teilen, verlieren die Teams die genaue Herkunft, die Durchsetzung des Prinzips der minimalen Berechtigungen wird erschwert und die Auswirkungen kompromittierter Anmeldeinformationen erhöhen sich.
Komponenten einer Workload-Identitätsarchitektur
Eine robuste Identitätsarchitektur für KI-Agenten beschränkt sich nicht auf die Ausstellung eines Zertifikats. Sie stellt eine Vertrauenskette dar, die die Arbeitslast verifiziert, die Identität feststellt, Richtlinien anwendet und Aktionen protokolliert.
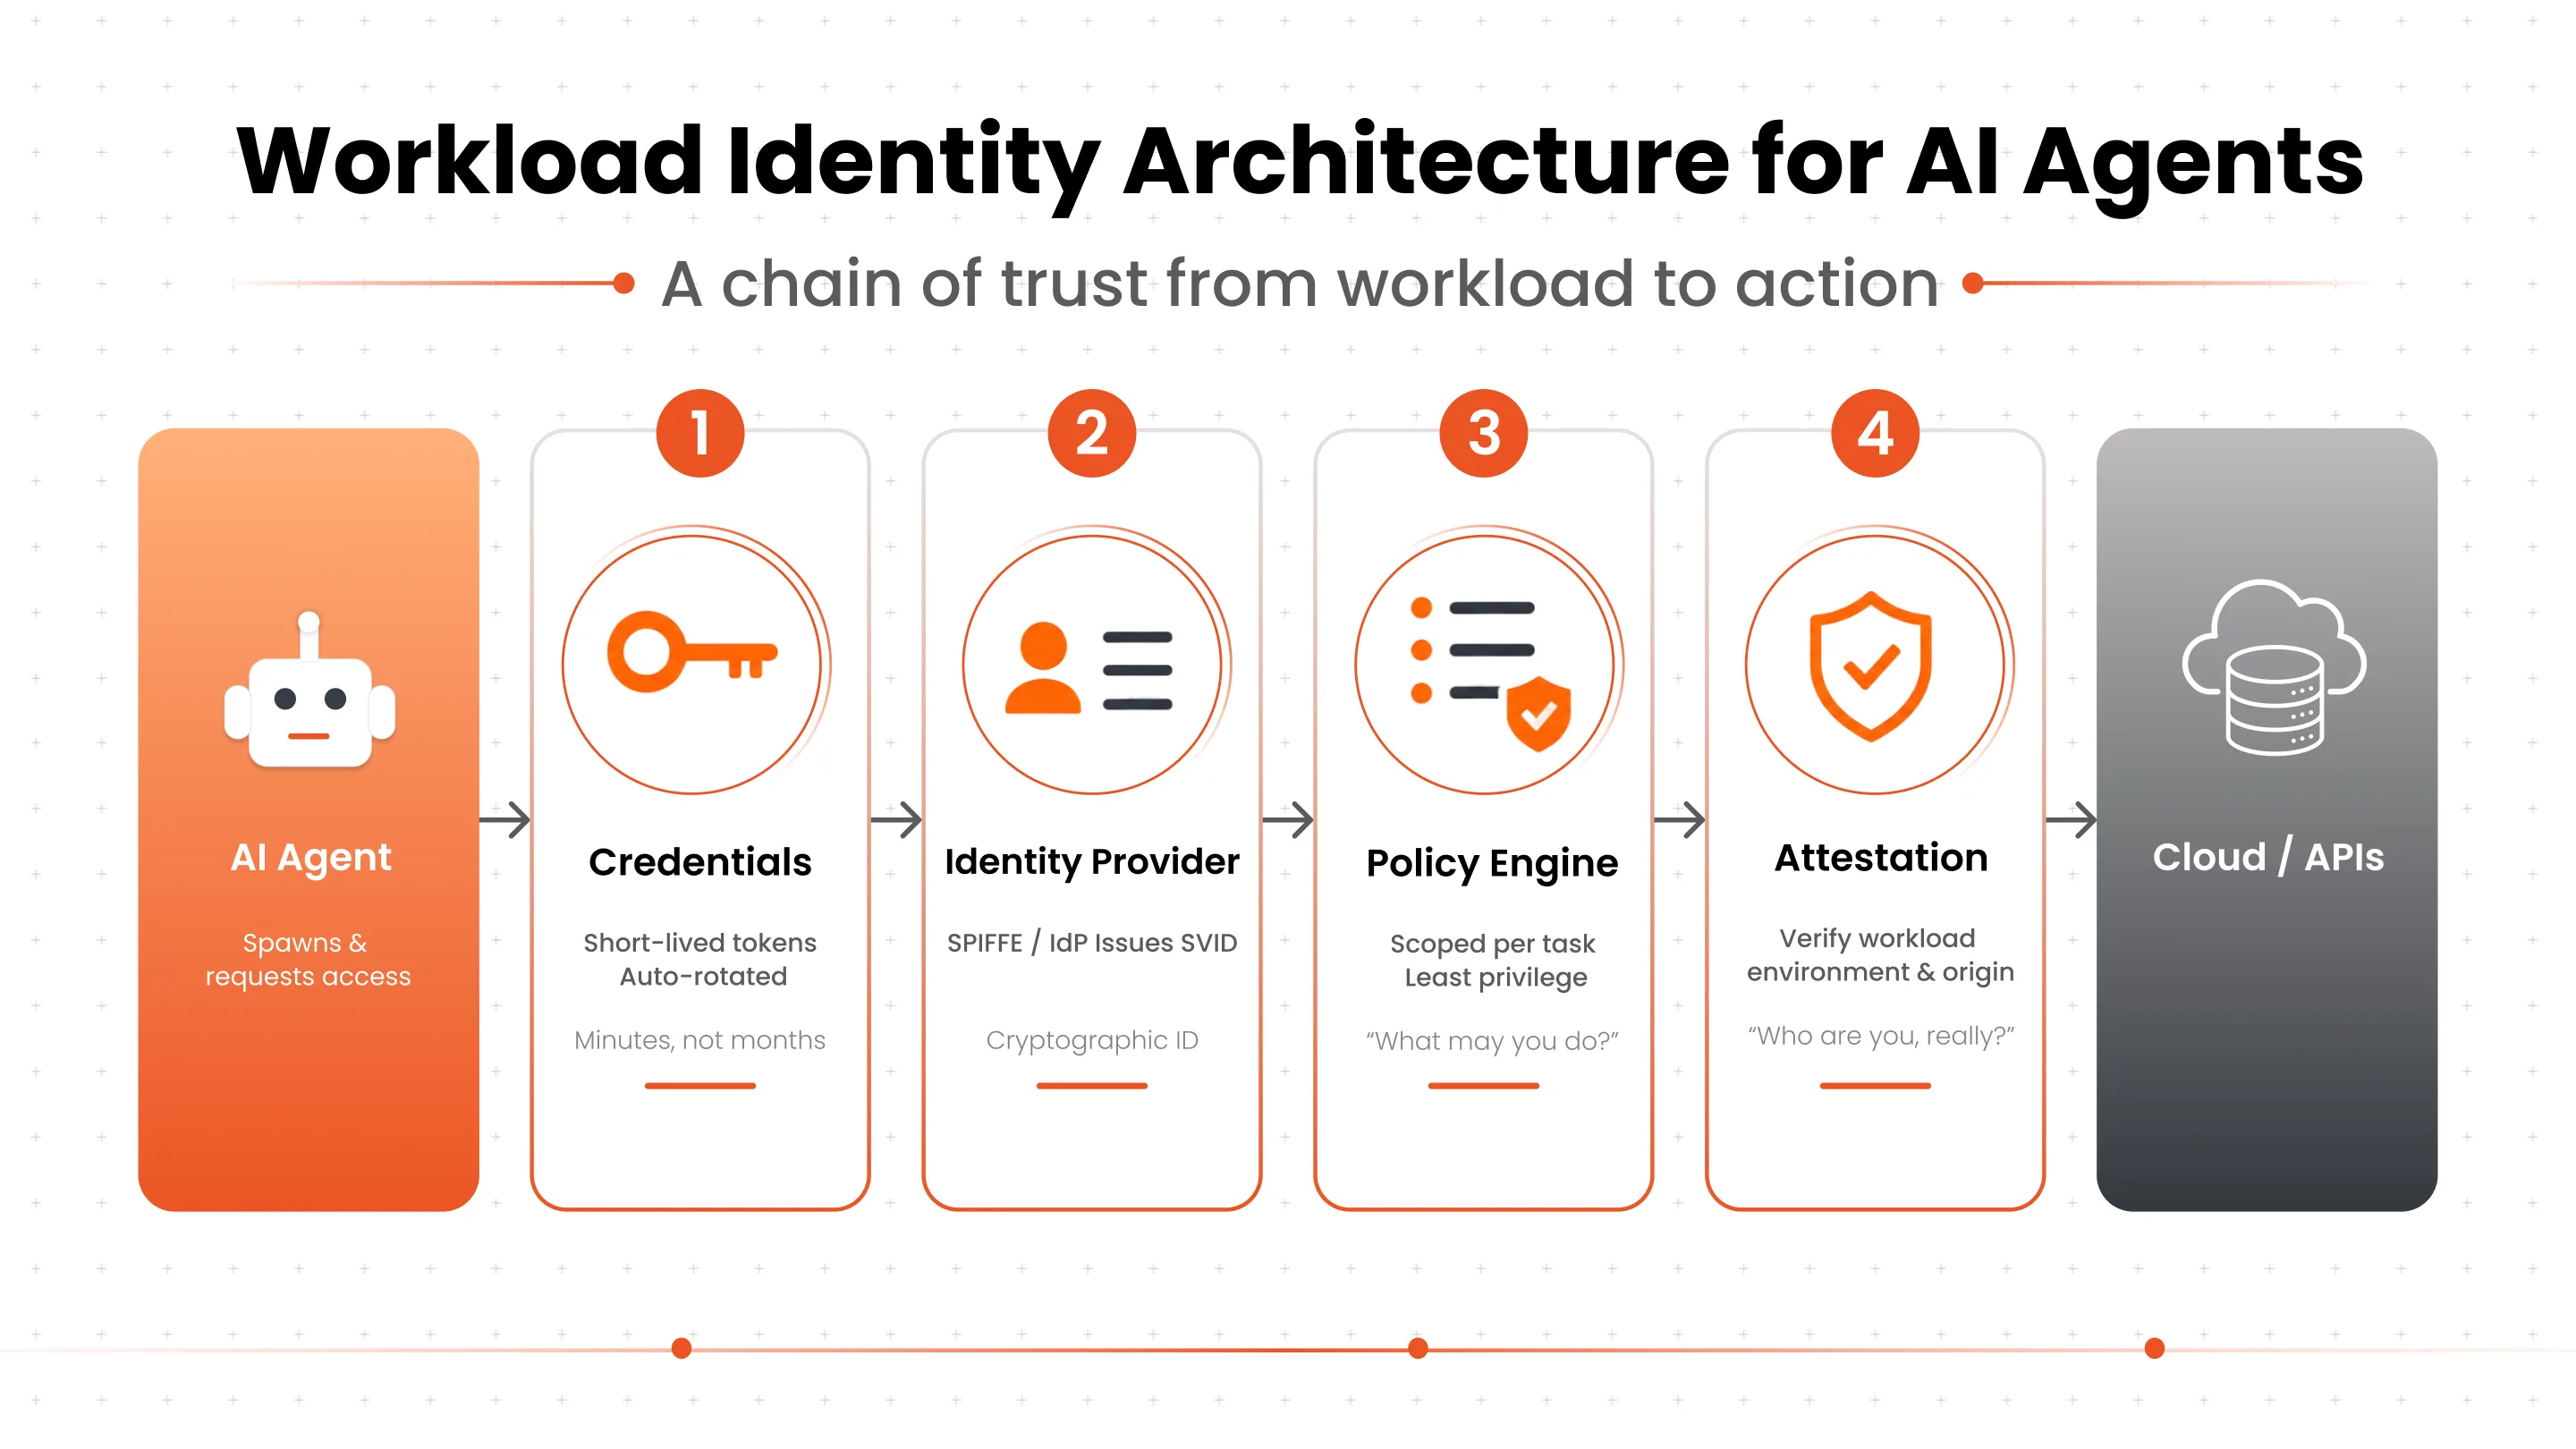
Wir betrachten die Komponenten, die zur Entstehung dieses Vertrauens beitragen.
- Anmeldeinformationsverwaltung: Diese Ebene rotiert, stellt aus und lässt kurzlebige Anmeldeinformationen automatisch ablaufen. Hauptziel ist es, statische Geheimnisse durch temporäre Anmeldeinformationen zu ersetzen, die nur bei Bedarf bereitgestellt werden.
- Identitätsanbieter (IdP): Dies fungiert als Instanz, die verifizierte Workloads vertrauenswürdigen Identitäten zuordnet. In manchen Umgebungen ist diese Funktion in die Cloud integriert. IAM oder einer Workload-Identitätsplattform anstelle eines traditionellen Workforce-IdP.
- Richtliniendurchsetzungs-Engine: Die Richtlinie legt fest, welche Tools, APIs, Datenquellen und Aktionen ein Agent unter welchen Bedingungen und für welchen Zeitraum nutzen darf.
- Workload-Attestierungsdienst: Bevor eine Identitätsprüfung durchgeführt wird, sollte das System einige Informationen über die Arbeitslast und ihre Umgebung überprüfen, z. B. wo sie ausgeführt wird, von welchem Image sie stammt oder ob sie die Sicherheitsanforderungen erfüllt.
Die Kosten der Ignorierung der Workload-Identität für KI-Agenten
Das Geschäftsrisiko schwacher KI-basierter Identitätskontrollen ist nicht theoretischer Natur. Es zeigt sich in Ausfällen, Untersuchungen von Datenschutzverletzungen, Verstößen gegen Compliance-Vorgaben und einer verlangsamten Entwicklungsgeschwindigkeit.
1. Ein einziges Berechtigungsproblem kann zu einem Ausfall mehrerer Systeme führen
Eine versäumte Verlängerung oder ein durchgesickertes Token kann weitreichende Folgen für verbundene Systeme haben, insbesondere wenn Maschinenidentitäten internen APIs, Automatisierungen und Serviceabhängigkeiten zugrunde liegen.
In einer KI-lastigen Umgebung verschärft sich dieses Problem, da ein einzelner Agent mehrere Tools nacheinander bedienen kann.
2. Gemeinsam genutzte Zugangsdaten erschweren die Untersuchung von Sicherheitsverletzungen
Wenn mehrere Agenten dieselbe Identität verwenden, wird die forensische Analyse schnell kompliziert. Die Teams können zwar feststellen, dass ein Konto eine Aktion ausgeführt hat, aber nicht unbedingt, welcher Agent diese initiiert hat, ob die Aktion autorisiert war oder ob die Ursache Missbrauch, Fehlkonfiguration oder Kompromittierung war.
3. Compliance und Qualitätssicherung werden schwieriger
Die Einhaltung von Vorschriften stand schon immer im Vordergrund. Unternehmen müssen sich an Rahmenwerke wie SOC 2, ISO 27001 und die Vorgaben regulierter Umgebungen anpassen. Daher ist es wichtig, den Auditoren klare Nachweise darüber zu liefern, wer wann und mit welcher Befugnis auf welche Daten zugegriffen hat.
4. Der Versand verlangsamt sich, wenn die Identität fragil ist.
Wenn Zugriffsmodelle fehleranfällig sind, werden Entwicklerteams konservativ. Sie verzögern Änderungen, vermeiden fein abgestufte Berechtigungen, weil diese schwer zu verwalten sind, und behalten vorerst einen breiten Zugriff bei, was die Bereitstellungsgeschwindigkeit stillschweigend, aber kostspielig bremst.
Die Dringlichkeit nimmt zu. Es ist an der Zeit, die Steuerung von KI-Agenten als organisationsübergreifende Anforderung zu betrachten, da jeder Agent Risiken birgt, Aktionen ausführt und eine zentrale Identität, Richtliniendurchsetzung und Transparenz benötigt.
Bewährte Verfahren zur Absicherung von KI-Agenten mit Workload-Identität
Die besten Strategien zur Workload-Identitätsverwaltung sind zwar subjektiv, aber praxisnah. Sie reduzieren Risiken, ohne Teams zu einer monatelangen Neugestaltung ihrer Identität zu zwingen.
1. Behandeln Sie jeden Agenten als Arbeitslast mit eigener Identität
Jeder Agent sollte von dem Moment an, in dem er erstellt oder eingesetzt wird, eine eindeutige, nicht-menschliche Identität besitzen. Diese Identität sollte nicht von einem menschlichen Benutzer übernommen, zwischen verschiedenen Agententypen geteilt oder als wiederverwendbares Geheimnis eingebettet werden.
2. Das Prinzip der minimalen Berechtigungen sollte pro Aufgabe und nicht pro Plattform durchgesetzt werden.
Vermeiden Sie weit gefasste Rollen, die einem Mitarbeiter dauerhaften Zugriff auf alles gewähren, was er jemals benötigen könnte. Beschränken Sie stattdessen die Berechtigungen auf die jeweilige Aufgabe, das benötigte Werkzeug und den entsprechenden Zeitraum. Dies ist eines der wichtigsten Prinzipien in IAM für agentenbasierte KI.
3. Temporäre Anmeldeinformationen standardmäßig bevorzugen
Wenn Anmeldeinformationen benötigt werden, sollten sie nur kurzlebig sein, automatisch erneuert werden und leicht widerrufen werden können. Dies ist eine der effektivsten Methoden, die Auswirkungen von Anmeldeinformationsdiebstahl zu reduzieren und die Sicherheit der Maschinenidentität zu verbessern.
4. Erstellen Sie einen signierten, nachvollziehbaren Prüfpfad
Die Kommunikation zwischen Agenten und Tools sowie zwischen Agenten untereinander muss nachvollziehbar sein. Der Prüfpfad sollte aufzeigen, welche Identität die Aktion ausgeführt hat, worauf zugegriffen wurde, ob die Aktion im Auftrag eines Benutzers stattfand und welche Richtlinie die Aktion erlaubte. Dies ist insbesondere bei delegierten KI-Workflows wichtig.
5. Identität als Eindämmungsmechanismus nutzen
Eine gut konzipierte Identitätsebene fungiert wie ein Not-Aus-Schalter. Sollte sich ein Agent unerwartet verhalten, sollten Teams in der Lage sein, diese spezifische Identität zu widerrufen oder unter Quarantäne zu stellen, ohne andere Dienste oder Arbeitsabläufe zu beeinträchtigen.
6. Planung der Multi-Protokoll-Authentifizierung
Gehen Sie nicht davon aus, dass ein einziger Identitätsstandard alle nachgelagerten Ziele abdeckt. KI-Agenten müssen häufig mit Cloud-Steuerungsebenen, SaaS-Anwendungen, APIs, internen Diensten und Modellanbietern interagieren.
Das richtige Vorgehen besteht darin, die Workload-Identität als Vertrauensanker zu verwenden und je nach Bedarf kurzlebige Anmeldeinformationen für jedes nachgelagerte Protokoll zu vermitteln.
Die Zukunft der Sicherheit von KI-Agenten liegt in der Identitätsfestlegung.
Die nächste Phase der KI-Sicherheit wird nicht dadurch erreicht, dass mehr Token an mehr Orten versteckt werden. Sie wird dadurch erreicht, dass Identitäten verifizierbar, kurzlebig, richtlinienkonform und in Maschinengeschwindigkeit zuordenbar gemacht werden.
Das ist die wahre Antwort auf die wachsende Identitätskrise im Bereich der KI. Die Frage lautet nicht mehr: „Kann man diesem Agenten vertrauen?“, sondern: „Kann dieser Agent seine Identität, seine Berechtigungen und die aktuelle Gültigkeit dieser Berechtigungen nachweisen?“ Workload-Identität bietet Unternehmen eine praktische Möglichkeit, diese Frage für jede Anfrage zu beantworten.
Mit zunehmender Integration von KI-Systemen in den Geschäftsbetrieb wird das Management nicht-menschlicher Identitäten zu einem zentralen Bestandteil der Sicherheitsarchitektur und nicht länger nur ein Nischenthema in der Cloud. Unternehmen, die frühzeitig auf Workload-Identitätsföderation, temporäre Anmeldeinformationen und Zero-Trust-KI-Systeme setzen, sind besser aufgestellt, um sicher zu skalieren, ohne Innovationen zu bremsen.
Häufig gestellte Fragen
Was ist Workload-Identität und warum ist sie für KI-Agenten wichtig?
Die Workload-Identität ist eine kryptografische Identität für eine nicht-menschliche Entität wie einen KI-Agenten, einen Dienst oder einen Container. Sie ist wichtig, da sie die Authentifizierung von KI-Agenten verbessert, eine strengere Zugriffskontrolle für KI-Agenten ermöglicht und die Abhängigkeit von langlebigen Geheimnissen verringert.
Worin besteht der Unterschied zwischen einer Workload-Identität und einem Dienstkonto?
Ein Dienstkonto ist oft eine wiederverwendbare Identität mit statischen oder langlebigen Anmeldeinformationen. Die Workload-Identität ist in der Regel pro Workload eindeutig, kurzlebig, richtliniengebunden und lässt sich in Protokollen und Audits leichter zuordnen.
Wie authentifizieren sich KI-Agenten sicher bei Cloud-Diensten?
Das sicherste Vorgehen besteht darin, zunächst eine vertrauenswürdige Workload-Identität zu erstellen und diese Identität dann zu verwenden, um die richtigen kurzlebigen Cloud- oder Anwendungsanmeldeinformationen für den Zieldienst zu erhalten.
Was ist SPIFFE und welche Bedeutung hat es für die Sicherheit von KI-Agenten?
SPIFFE ist ein offener Standard für die Workload-Identität, der die Zuweisung kryptografisch verifizierbarer Identitäten zu Workloads ermöglicht. Für die Sicherheit von KI-Agenten ist er besonders als zentrale interne Identitätsschicht nützlich.
Welche Risiken bergen Shared-Service-Accounts für KI-Workloads?
Sie schwächen die Zuordnung von Vorfällen, vergrößern den Wirkungsbereich, erschweren die Einhaltung des Prinzips der minimalen Berechtigungen und verkomplizieren die Reaktion auf Sicherheitsvorfälle. Diese Probleme verschärfen sich mit zunehmender Anzahl von Agenten und Integrationen.
Wie lässt sich das Zero-Trust-Prinzip auf nicht-menschliche Identitäten anwenden?
Zero Trust für nicht-menschliche Identitäten bedeutet, dass jede Anfrage anhand der verifizierten Identität, des Kontexts und der Richtlinien bewertet wird, anstatt auf implizitem Vertrauen zu beruhen. Für KI-Agenten bedeutet dies in der Regel eine starke Workload-Identität, kurzzeitigen Zugriff, das Prinzip der minimalen Berechtigungen, Beobachtbarkeit und schnellen Widerruf.



Hinterlasse einen Kommentar